llms

图像到图像的人工智能:重新风格化、重新想象和混合您的图像

Viddo AI的图像到图像AI可以将任何照片转变为全新的视觉效果,无需重新拍摄。上传一张图片,从20多个旗舰图像到图像模型中选择——GPT Image、Seedream、Nano Banana、Midjourney——并在几秒钟内对输出进行风格重塑、重新构思或混合,所有操作都在一个画布上完成。

使用人工智能生成

如果您不满意,可以重新生成或输入您自己的提示。

选择图像的纵横比

1:1

3:2

2:3

Medium
High
所需积分: 0

Waiting for your creations!

Viddo AI上的图像到图像AI生成器

使用我们的图像到图像工具,轻松将您的照片转变为令人惊叹的新视觉效果,非常适合创意项目、广告活动和社交媒体内容。

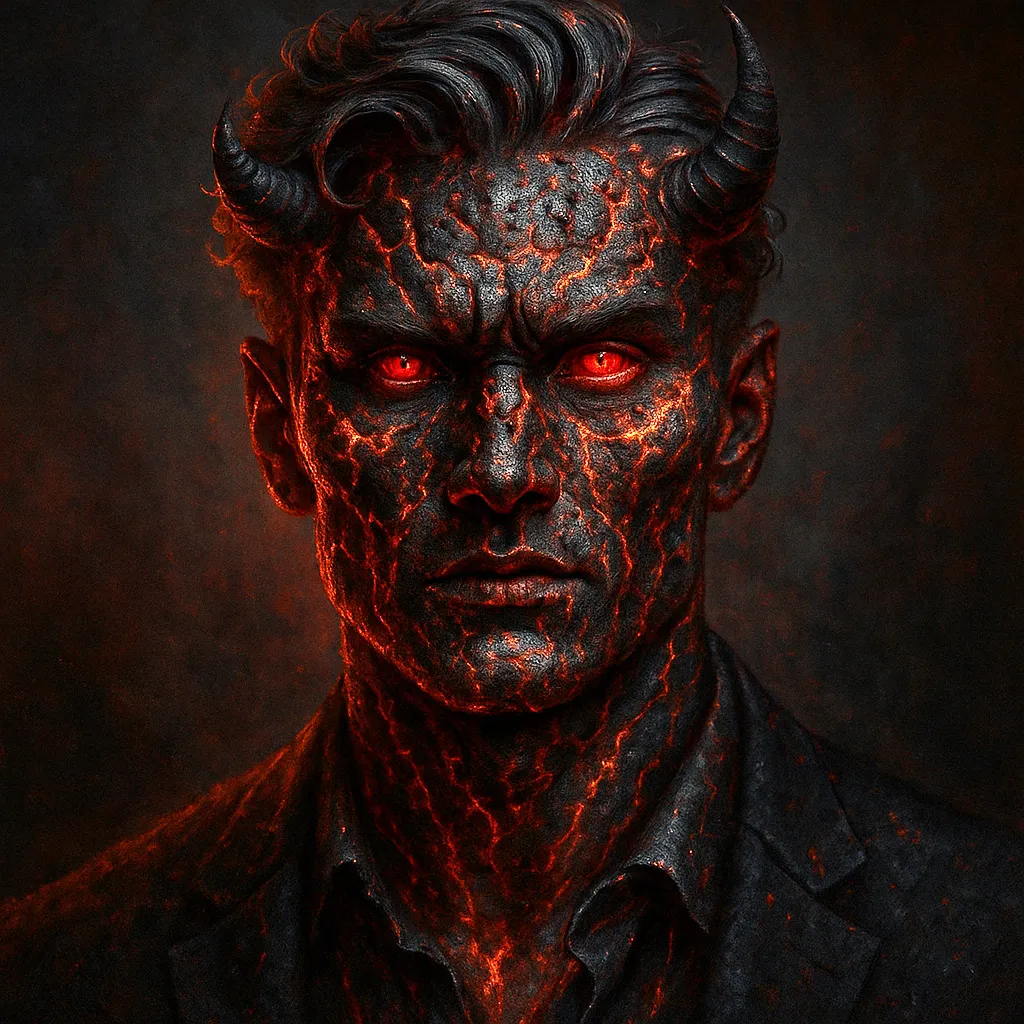
  • Silver-haired man in suit: source image for Viddo AI image to image transformation
    Demonic man with glowing red skin: AI reimagined result from Viddo AI image to image
  • Luxury mechanical watch: base image for Viddo AI image to image style transfer
    Cyberpunk sci-fi watch: futuristic redesign via Viddo AI image to image
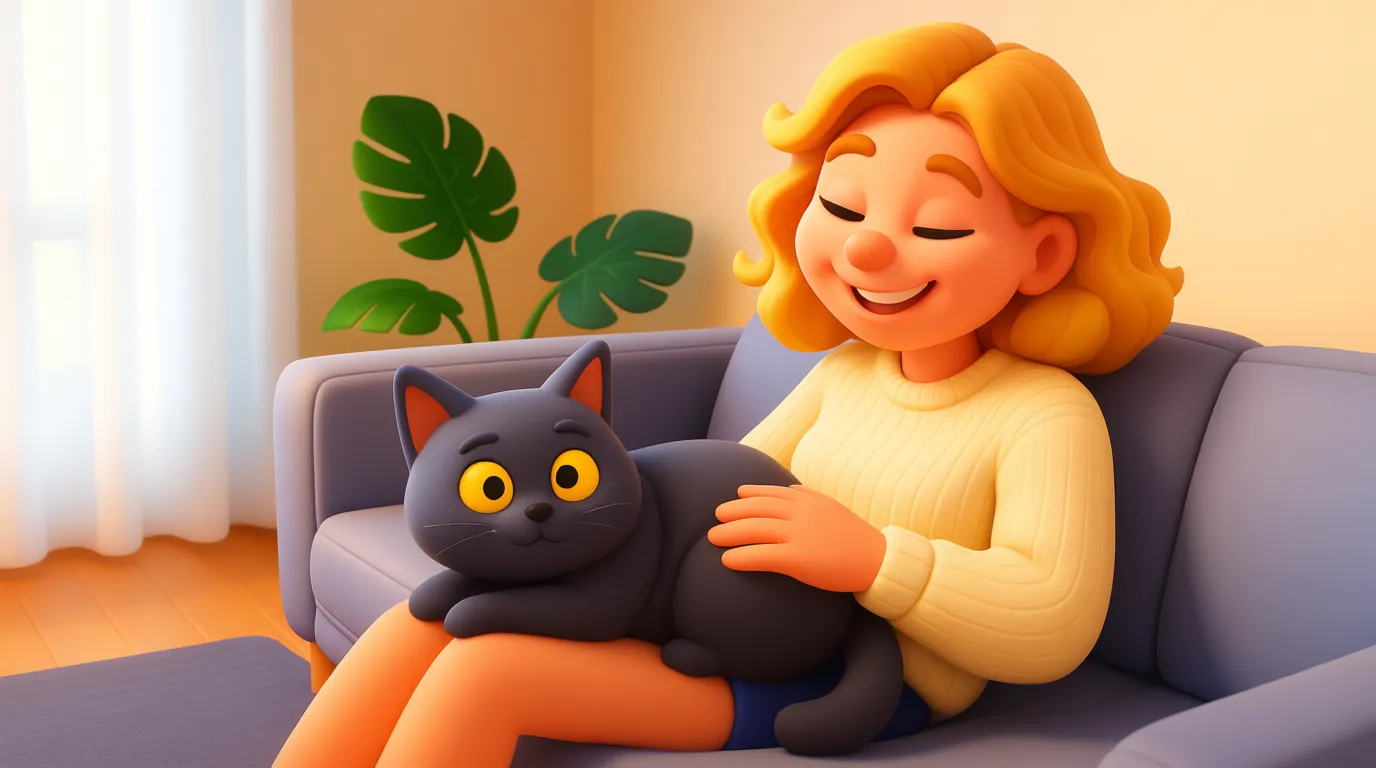
  • Woman with grey cat on couch: source photo for Viddo AI image to image
    Cartoonized woman with cat: playful illustration from Viddo AI image to image
  • Woman with grey cat on couch: source photo for Viddo AI image to image
    Cartoonized woman with cat: playful illustration from Viddo AI image to image

图像画布:在Viddo AI上编辑您标记的地方

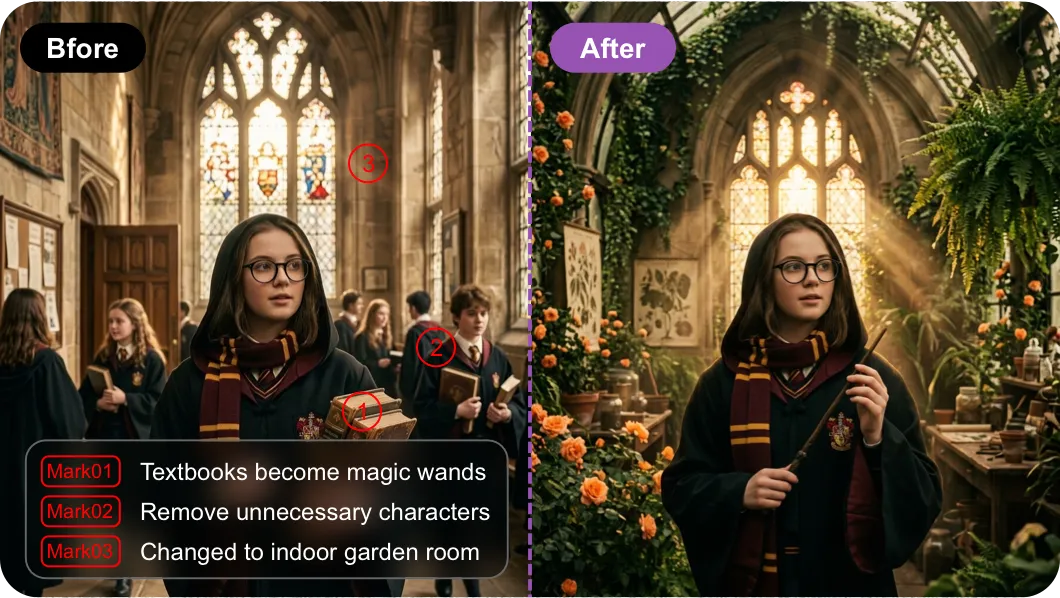
虽然上面的图像到图像生成器根据文本提示重新设计整个画面,但Viddo AI的图像画布是在线编辑的伴侣,适用于需要更改某个区域的情况。
image

标记模式 — 点击编辑区域

从标记调色板中选择一种颜色(红色、绿色、蓝色、紫色、白色),涂抹您想要更改的区域,油漆将变成一个命名标签——@Mark01,@Mark02,以此类推。在您的提示中引用该标签,模型仅编辑该区域;外部的所有内容保持像素不变。
image

涂鸦模式 — 在上面绘制新形状

涂鸦模式是标记的反向操作——直接在图像上方勾勒出新形状,模型会用照片级细节填充它。标记 + 涂鸦可以在同一编辑中结合:标记区域,涂鸦接下来要出现的内容,然后生成。

Viddo AI图像到图像的主要特点

一个上传区域内的20多个图像到图像模型
选择器包含来自五个家族的14个模型——OpenAI、Google、字节跳动、xAI和Midjourney——每一个模型都是真正的图像到图像,而不是在文本到图像上加了过滤器。每个模型都有自己独特的风格指纹和提示敏感度,因此正确的选择取决于您需要的外观。

每个模型都位于相同的上传区域和相同的提示编辑器后面,因此在切换时输入格式始终保持不变。专门页面深入探讨每个模型的提示风格:Seedream 4.5、Nano Banana Pro 和 Midjourney。
一个上传区域内的20多个图像到图像模型
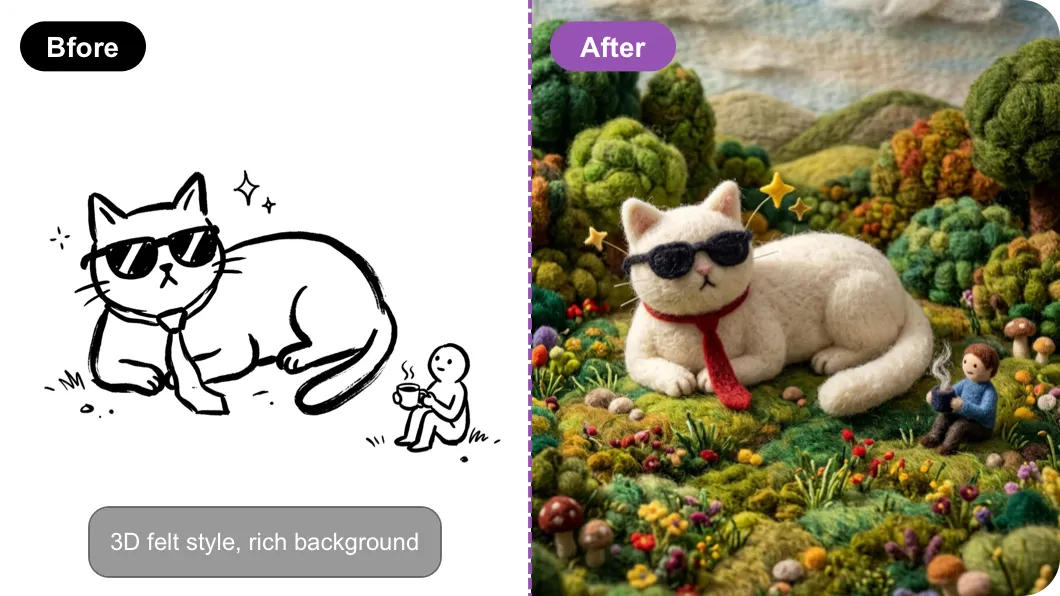
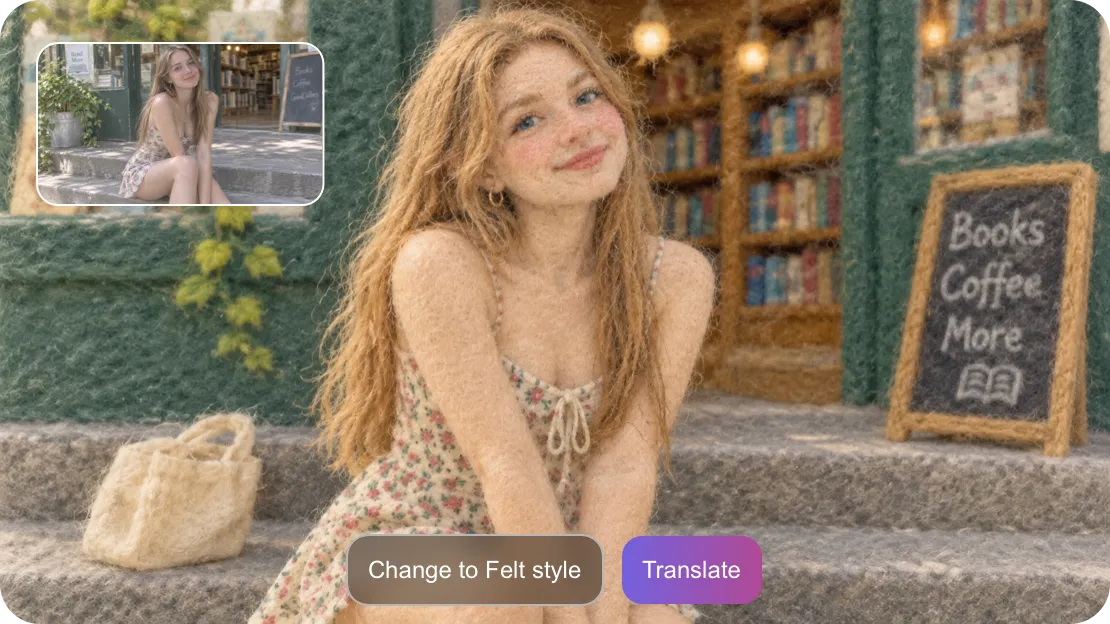
文本提示的风格迁移
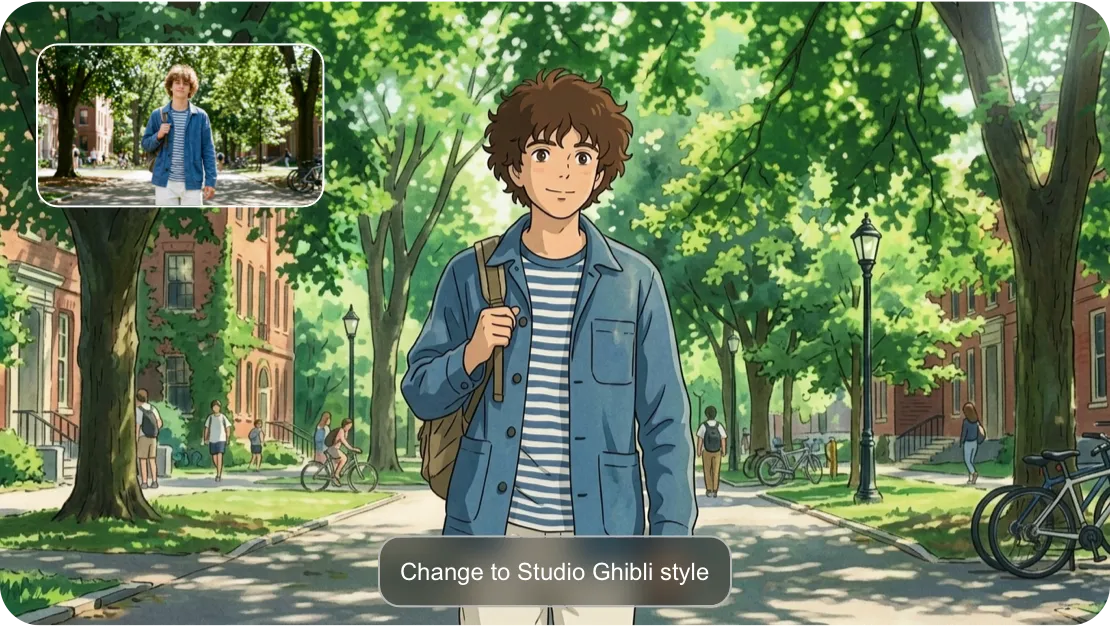
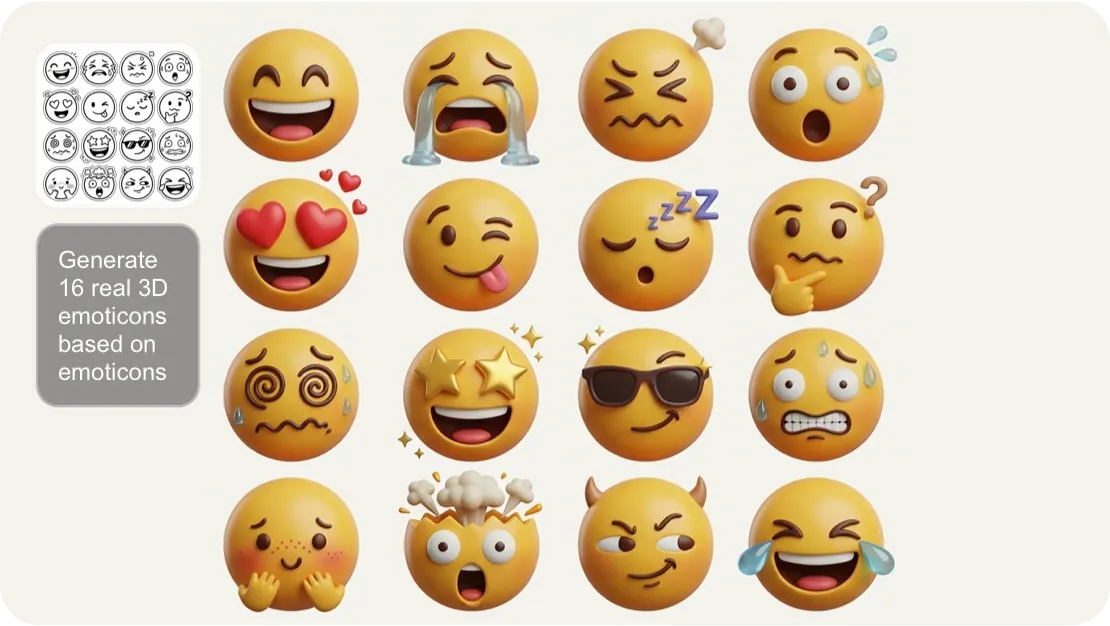
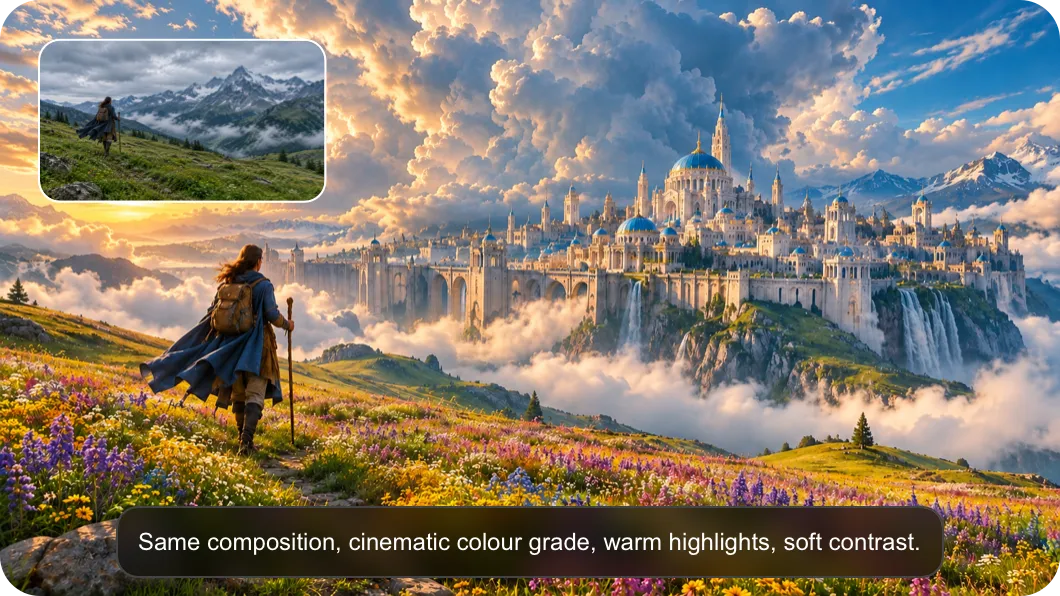
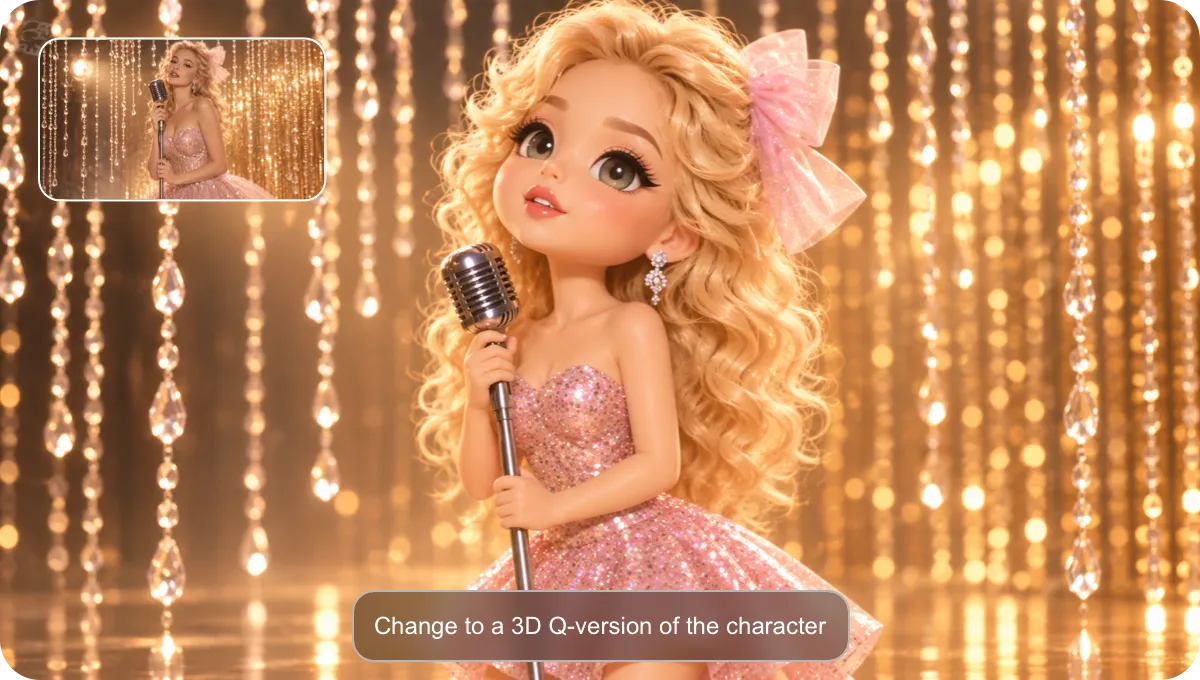
图像到图像的AI生成器将风格转移视为一流输出。选择一个与目标美学相匹配的模型——动漫、电影、粘土动画、水彩、照片真实感——该模型会在保留原始构图的同时,以该风格重新渲染照片。源照片驱动结构,提示驱动外观,而模型保持从角落到角落的一致性。这是动漫重塑、音乐视频调色、品牌KV一致性和短视频广告再利用背后的工作流程——写一个简短的提示,比如“相同构图,电影色彩分级”,然后模型就会完成其余部分。
文本提示的风格迁移
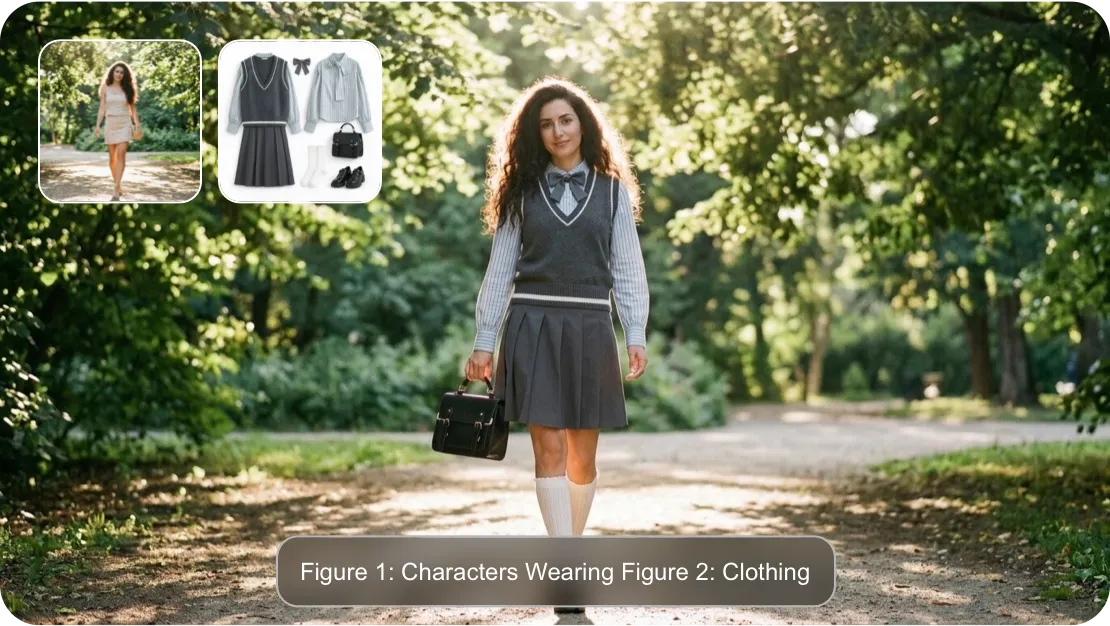
在一个简报中最多可包含16张参考图像
Viddo AI上的图像到图像AI生成器在单个简报中最多接受16张参考图像。将源图像拖入上传区域,添加与目标风格、情绪或角色匹配的参考照片,模型会在工作时对每个参考进行索引。画布中的上传计数器显示为`image(0/16)`,因此您始终知道该简报还可以吸收多少个参考。多重引用是品牌KV系列、角色转身表、多格式活动视觉以及任何需要在多个输出中保持稳定身份的简报背后的工作流程。
在一个简报中最多可包含16张参考图像
纵横比、分辨率和版本控制
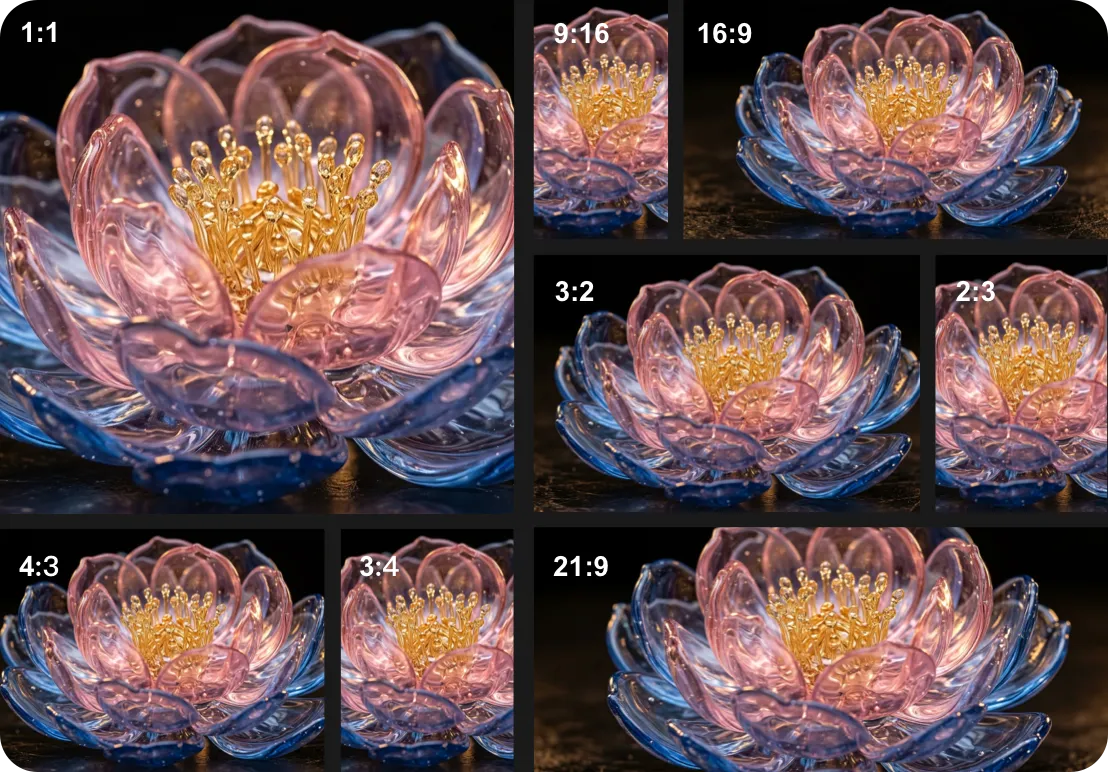
图像到图像的AI生成器提供9种纵横比(自适应、1:1、16:9、9:16、4:3、3:4、3:2、2:3、21:9)、三个分辨率等级(1K,2K,4K)以及在支持的模型上有两个版本(Flare和Sunburst),以便输出符合放置要求。选择1:1用于社交头像,9:16用于故事剪辑,16:9用于主视觉横幅,或选择自适应让模型选择与源匹配的比例。选择1K进行快速迭代,4K进行最终导出,并在Flare和Sunburst之间切换,以比较同一提示下同一模型的两次生成结果。
纵横比、分辨率和版本控制
系列视觉一致性的种子锁定
Viddo AI上的图像到图像AI生成器提供了种子锁定控制:选择一个种子后,每次使用相同的提示和种子运行都会返回相同的风格指纹、角色外观和调色板基线。正如屏幕上的工具提示所解释的那样,“通过使用相同的种子值,您可以尽可能保持图像的风格和角色外观的一致性——非常适合创建系列或维护视觉一致性。” 种子锁定是品牌KV系列、分集角色艺术、多格式活动剪辑以及任何需要在多个图像中保持稳定身份的简报背后的工作流程。
系列视觉一致性的种子锁定
多语言简报翻译提示
Viddo AI上的图像到图像AI生成器在提示编辑器旁边提供了一键翻译按钮:可以用16种支持的语言中的任何一种撰写简要说明,Viddo AI会在内容传递给图像到图像AI模型之前,将其重写为模型首选的提示风格。翻译是多语言活动制作、跨区域电子商务列表以及任何以一种语言进行简报并向另一种语言交付的团队背后的工作流程。Viddo AI在下拉菜单中每个模型旁边都保留了翻译按钮,因此同样的一键翻译功能贯穿整个11个模型系列。
多语言简报翻译提示

Viddo AI上的图像到图像提示示例

Every prompt below follows a 5-part structure that Viddo AI's Image to Image models recognise reliably:

StyleSubjectReferenceAspectMood

Use a 3-part brief (Style + Subject + Mood, 5-9 words) when the source photo already supplies the Reference and Aspect.

Use a 5-part brief (10-15 words) when you need to pin the face, product, or crop explicitly.

同一构图的电影色彩分级,具有温暖的高光和柔和的对比度。

提示 1 — 电影色彩分级

结构

风格:电影色彩分级
主题:相同构图
参考:(无 - 使用源照片)
纵横比:(源比例)
氛围:温暖的高光,柔和的对比

为什么有效

  • 相同构图 — 告诉模特保持布局,仅重新设计风格
  • 电影色彩分级 — 触发广泛的色域 + 青橙分调效果在GPT图像2和Seedream 4.5上
  • 温暖的高光,柔和的对比 — 锁定照明偏差,使每次重跑看起来一致
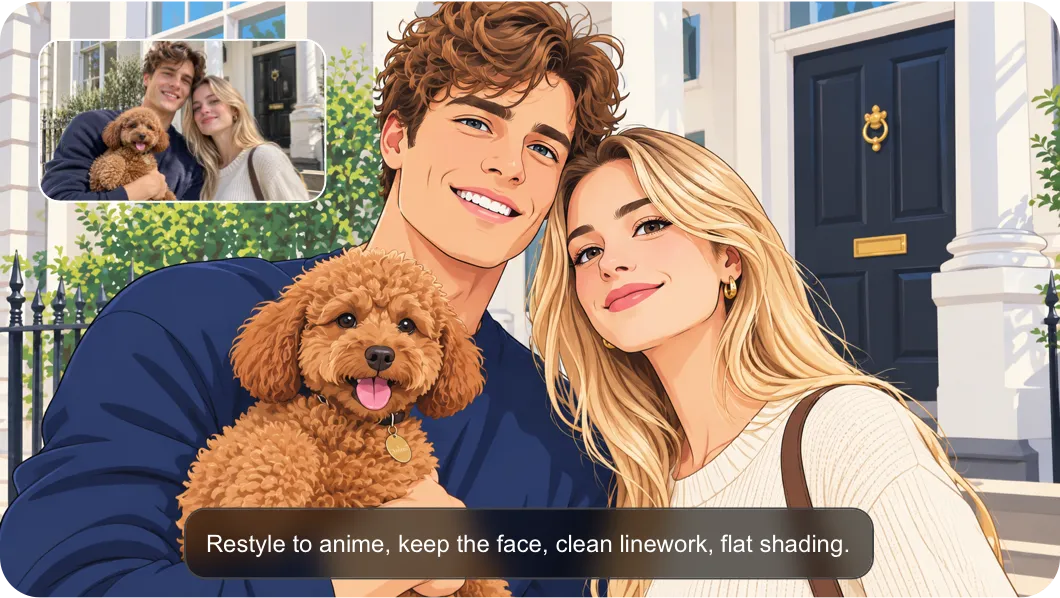
保持原始面孔的动漫重塑,具有干净的线条和扁平阴影。

提示2 — 动漫重新皮肤与面部锁定

结构

风格:动漫
主题:重新设计为动漫
参考:保持面部特征
比例:(源比例)
氛围:干净的线条,平坦的阴影

为什么有效

  • 保持面部特征 — Nano Banana Pro 和 Midjourney 在明确指示时都能保留身份
  • 动漫 + 干净的线条,平坦的阴影 — 缩小了动漫子风格,以便模型在每次运行时不会选择不同的动漫美学
  • 非常适合角色转身图纸 — 在系列中与 Seed Lock 配对使用
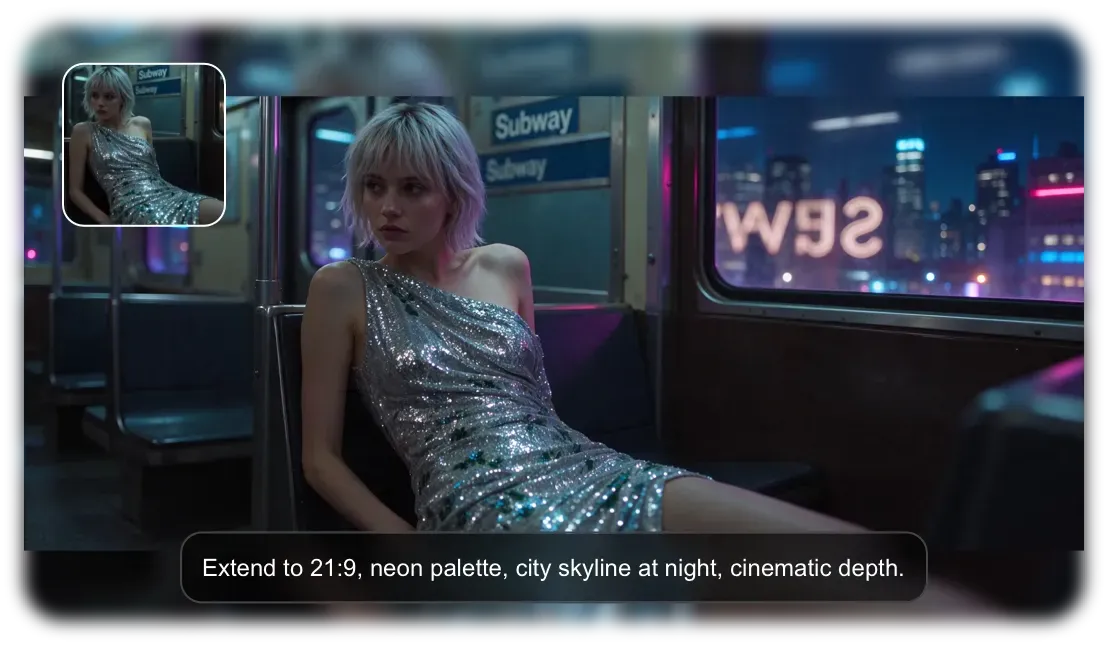
城市天际线扩展到21:9的电影画幅,配以霓虹色调。

提示 3 — 横向扩展至 21:9

结构

风格:电影感
主题:扩展至21:9
参考:城市天际线
纵横比:21:9
氛围:霓虹调色板,电影深度

为什么有效

  • 扩展至21:9 — 确定裁剪目标;模型用相同的美学填充新的边缘
  • 夜间城市天际线 — 为扩展的边缘提供内容锚点(而不是通用模糊)
  • 电影深度 — 推动Seedream 5 Pro和GPT图像2朝向前景/中景/背景分层
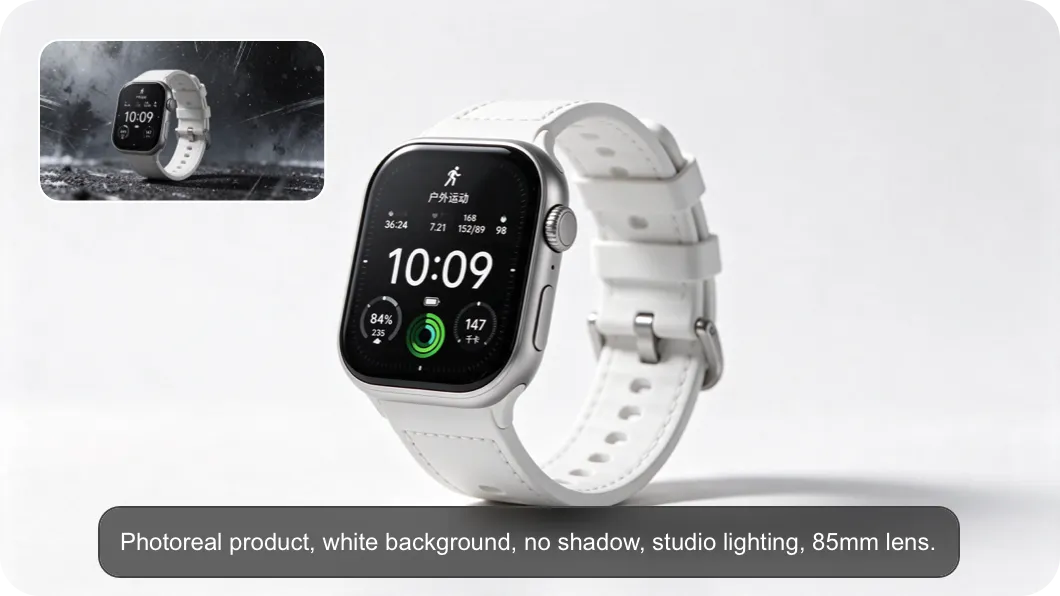
产品照片在白色背景上,使用摄影棚灯光且没有阴影。

提示 4 — 白色背景上的产品

结构

风格:照片真实
主题:白色背景上的产品
参考:源产品
纵横比:1:1
氛围:摄影棚灯光,无阴影,85mm镜头

为什么有效

  • 白色背景,无阴影——最干净的电子商务主图简报;GPT Image 2和GPT-4o都做得很好
  • 85mm镜头——一个真正的焦距,在照片真实模型上触发产品摄影行为
  • Amazom / Shopify / Etsy 列表可直接使用
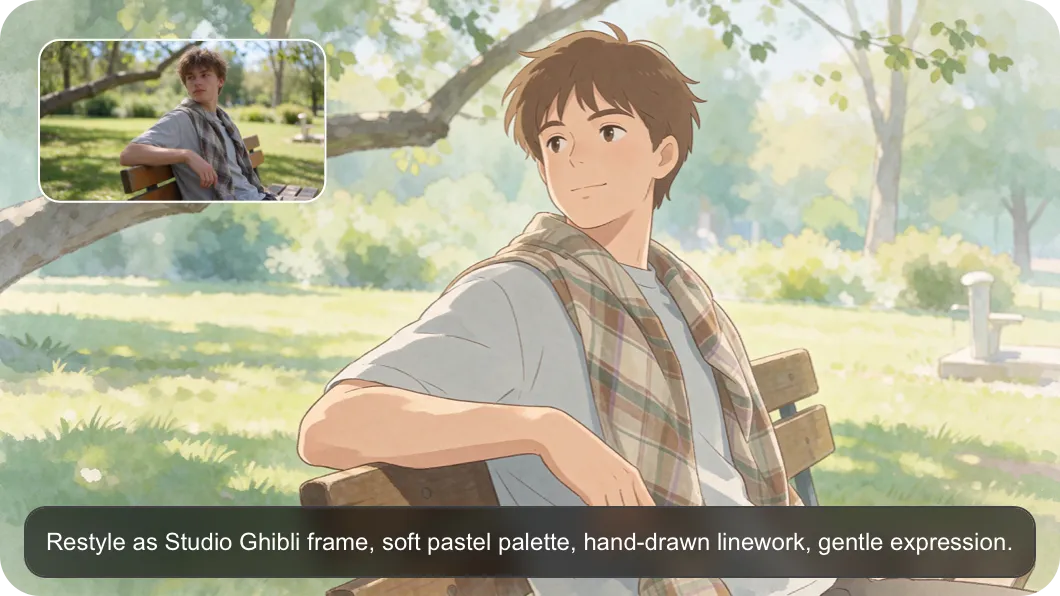
宫崎骏工作室插图,采用柔和的粉彩调色板和手绘线条。

提示5 — 吉卜力插图

结构

风格:吉卜力插图
主题:重新设计为插图
参考:(源照片作为构图锚点)
比例:(源比率)
氛围:柔和的粉彩调色板,手绘线条,温和的表情

为什么有效

  • 吉卜力——一个Midjourney和Grok Imagine都认可的具体参考,而不是模糊的动漫
  • 柔和的粉彩调色板 + 手绘线条——锁定了颜色温度和笔触风格
  • 温和的表情——引导模型朝向友好、无威胁的人物形象工作
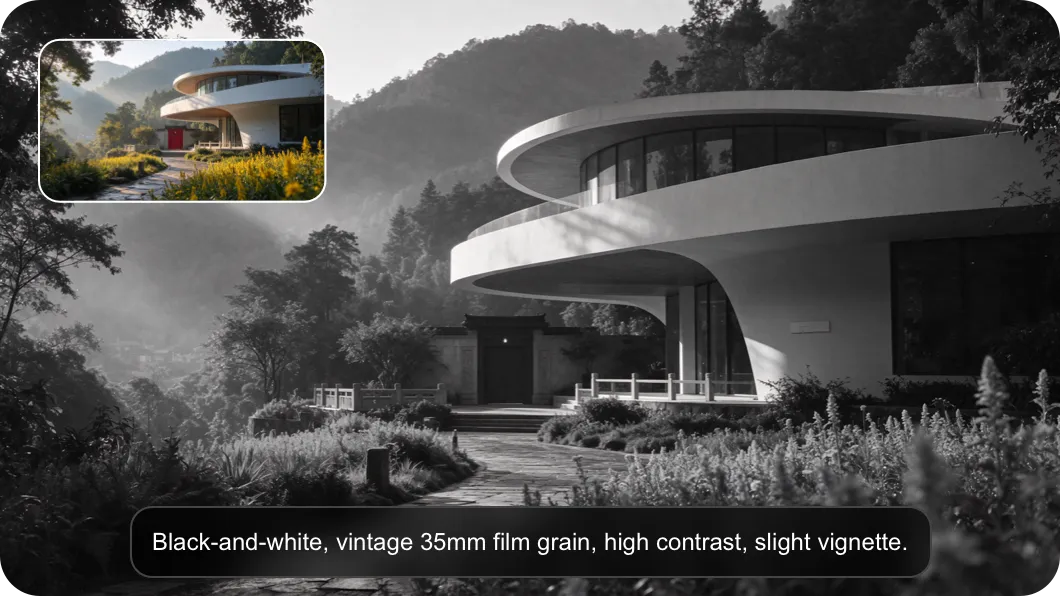
黑白复古照片,带有35毫米胶卷颗粒,高对比度和轻微的渐晕效果。

提示6 — 黑白胶卷颗粒

结构

风格:黑白复古
主题:(源照片)
参考:(无)
比例:(源比例)
氛围:35mm胶卷颗粒,高对比度,轻微渐晕

为什么有效

  • 复古的35mm胶卷颗粒——明确引用了一种胶卷类型,GPT Image 1.5和Seedream 4.5都映射到一种已知的美学
  • 高对比度——锁定色调曲线
  • 轻微渐晕——在不压倒构图的情况下增加了边框效果
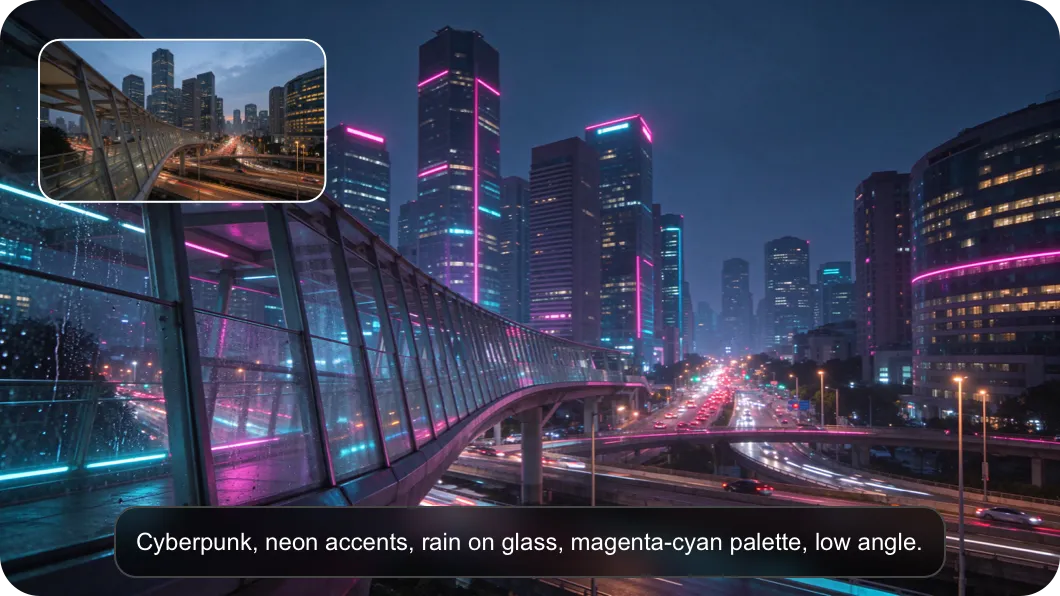
赛博朋克风格,16:9比例,带有霓虹色调、雨滴在玻璃上,以及品红-青色调。

提示7 — 赛博朋克音乐视频

结构

风格:赛博朋克
主题:(源照片)
参考:(无)
纵横比:16:9
氛围:霓虹色调,玻璃上的雨,品红-青色调,低角度

为什么有效

  • 品红-青色调 — 一种特定的颜色组合,使Seedream 5 Pro和Grok Imagine朝向科幻音乐视频美学发展
  • 玻璃上的雨 — 增加了质感而不改变构图
  • 低角度 — 摄影机提示戏剧性地重新框定主体
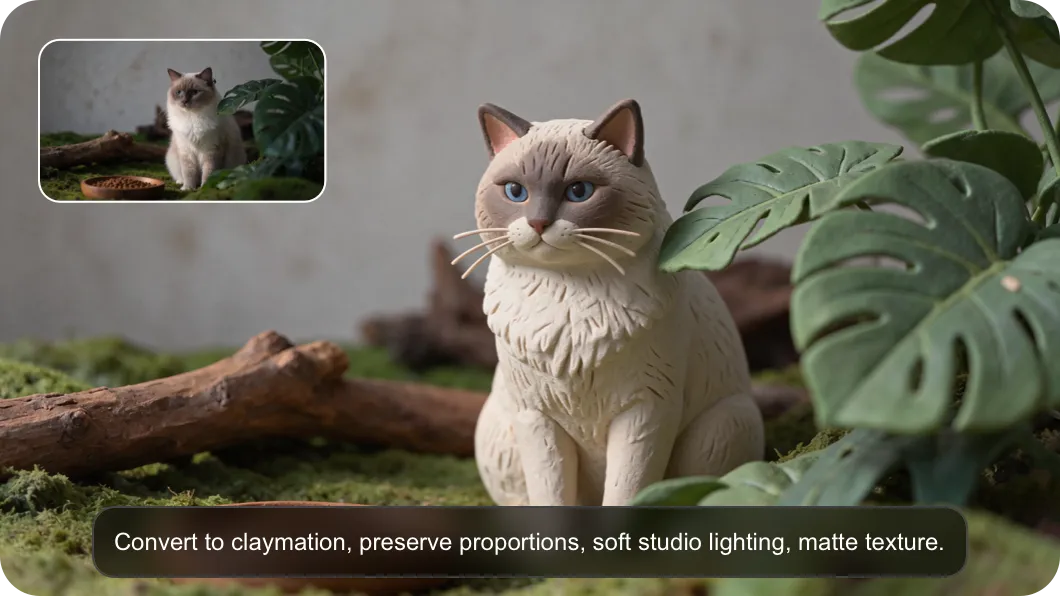
保持比例的粘土动画重新风格,采用柔和的工作室灯光和哑光质感。

提示8 — 粘土动画重新皮肤

结构

风格:粘土动画
主题:转换为粘土动画
参考:(源照片)
比例:(源比例)
氛围:保持比例,柔和的工作室灯光,哑光质感

为什么有效

  • 保持比例 — Midjourney 和 Grok Imagine 都尊重这一点,保持源轮廓完整
  • 粘土动画 + 哑光质感 — 缩小了定格动画的美学,使模型选择粘土而非塑料或蜡
  • 柔和的工作室灯光 — 消除了任何不应出现在粘土上的强烈高光

如何使用图像到图像的人工智能

1
打开图像到图像工具
在任何现代浏览器中打开 viddo.ai/image-to-image。只需点击一下即可登录或创建一个Viddo AI账户。图像到图像的画布直接加载在该网址上。模型选择器、上传区域、提示编辑器、纵横比和分辨率控制、生成按钮以及最新和历史标签已经显示在屏幕上。不需要跳转仪表板,也不需要将模型切换到单独页面。
2
选择一个模型并上传您的图片
点击画布顶部的模型选择器,选择11个图像到图像AI模型中的任何一个——可以先使用GPT 2.5 Image进行快速初步处理,或者直接跳到Seedream 5 Pro、Nano Banana Pro或Midjourney以获得特定风格。将源图像拖放到上传区域,或点击从设备中选择一张。上传计数器显示`image(0/16)`,让您知道还有多少参考空间可用。
3
写一个提示(或点击翻译)
在提示编辑器中输入简短的指令——描述您希望新图像传达的风格、情绪或变化。保持提示在5到15个单词之间,以获得最佳效果。如果您使用非英语语言进行简报,请点击提示编辑器旁边的翻译按钮,Viddo AI将为所选模型重写提示。
4
选择纵横比和分辨率,然后生成
选择与放置相匹配的纵横比(1:1、16:9、9:16、4:3、3:4、3:2、2:3、21:9或自适应)和分辨率等级(1K、2K或4K)。点击生成,查看结果出现在最新标签中,在同一简报上切换模型而无需重新上传,当效果合适时下载最终输出。

谁可以从图像到图像工具中受益

营销人员和广告创意者

将产品照片转化为用于付费社交、电子邮件和展示的风格化活动视觉。图像到图像的AI生成器非常适合创建变体和模型,用于A/B测试、季节性促销和渠道特定裁剪——在一个工作空间中,从同一源照片制作1:1的Instagram裁剪、9:16的故事裁剪以及16:9的主横幅。

内容创作者和影响者

为社交媒体动态和短视频缩略图生成引人注目的主题视觉效果。图像到图像的AI生成器帮助创作者在一系列作品中保持一致的视觉身份——相同的角色、相同的色调、相同的构图——无需预订摄影棚或为每个变体支付修图师费用。

摄影师和视觉讲述者

增强照片,生成替代版本,并添加艺术效果,而不离开原始的RAW风格构图。图像到图像的AI生成器为摄影师提供了一种快速测试色彩等级、情绪处理和风格化重渲染的方法,用于编辑提案、客户审查和作品集扩展——一次上传可以在一个下午变成十几种创意方向。

游戏设计师和概念艺术家

通过将角色、环境和道具从粗略的想法发展为精致的视觉效果,加快概念开发。图像到图像的AI生成器可以快速将草图重新渲染为完成的概念插图、转身表或多角度角色研究。多参考上传区域专为道具表、情绪参考和需要在多个资产之间保持一致性的光照研究而设计。

数字艺术家和插画师

重新构思草图,增强作品,或以最小的努力探索新的艺术风格。图像到图像的AI生成器将粗略的线条画重新渲染为所选风格的完成插图——水彩、墨水、平涂、油画、丝网印刷——同时保留艺术家的原始构图。使用种子锁定功能,使角色在一系列风格实验中保持可识别性。

电子商务卖家和产品营销人员

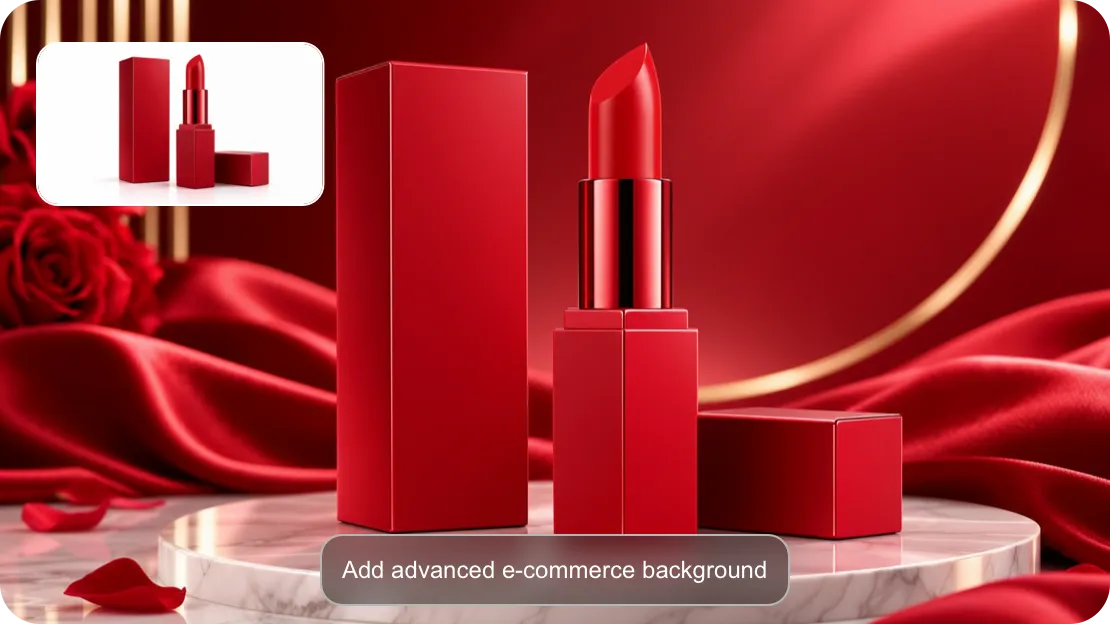
将一张白色背景的产品照片转化为完整的营销资产库:生活方式展示、季节氛围、礼品准备好的主图以及平台特定裁剪。图像到图像的AI生成器将多参考上传区域与9比率选择器配对,因此单个产品照片可以在一个工作区中变成完整的零售套件——Instagram方形、Stories竖版、市集主图和电子邮件横幅。

在Viddo AI上快乐的图像到图像用户

莉娜·M,概念插画师

Viddo AI的图像到图像生成器彻底改变了我作为数字艺术家的工作方式。我将一幅粗略的线条画放入上传区域,选择Midjourney或Nano Banana Pro,然后得到一幅完成的插图,这种风格我本来需要花两天时间去绘制。Seed Lock确保我的主角在12页系列中保持可识别性——每一页都是同样的面孔,同样的调色板。

克里斯·T,自由设计师

我每周使用图像到图像工具为五个保留客户制作活动视觉效果。我上传客户的产品照片,输入简短的提示,然后在一个下午内生成1:1、9:16和16:9版本的相同创意。我的Photoshop工作时间减少了约70%,而且客户反馈更清晰,因为从一开始这些变体看起来就很有意图。

摩根·L,品牌策略师

作为一名营销人员,我需要一个工具,可以将一张品牌照片转化为整个季节的社交资产,而不失去品牌关键视觉。Viddo AI 的图像到图像生成器正好满足了这一需求——种子锁加上多参考上传区域使我们的主打产品在夏季、秋季和假日版本中保持可识别性。11款模型阵容意味着我可以在同一个简报中对 Midjourney 和 Nano Banana Pro 进行 A/B 测试,并选择适合渠道的外观。

德夫·R,内容创作者

我已经在社交媒体上发布了六个月的AI风格肖像。Viddo AI是第一个让我可以用印地语简报、点击翻译,并且无需手动重写简报就能生成完成的英文提示的工具。4K输出足够清晰,可以打印,9:16剪辑直接适用于短视频,而在同一张源照片上切换GPT Image 2和Grok Imagine为我的动态提供了观众一直要求的多样性。

亚历克斯·K,摄影师

我一直在通过Viddo AI的图像到图像生成器为我的肖像作品集添加AI风格化的变体。相同模型的Flare和Sunburst版本是一个有用的A/B对 — 我会将两者展示给客户,让他们选择外观。Seed Lock控制使这个工作流程值得信赖:我可以在两周后回到简报,角色仍然看起来像同一个人。

贾伟,独立电影制作人

图像到图像生成器帮助我在一个下午内为我的短片制作了完整的情绪板。我上传了每个场景的静态画面,为每个场景添加了12个参考框架,并通过Nano Banana Pro和Seedream 5 Pro运行,每个都附上简短提示。历史标签保留了每次迭代,因此我可以比较不同模型之间的情绪处理,而不会丢失任何草稿。

了解更多关于图像到图像的人工智能工具

1

什么是图像到图像的人工智能生成器?

图像到图像的AI生成器是一种工具,它以现有照片作为输入,并根据文本提示返回转换后的照片。Viddo AI的图像到图像生成器将11个旗舰图像到图像模型汇集在一个画布上,因此您可以在不同模型之间重新设计、重新构思或混合相同的源照片,而无需重新上传。

2

我需要设计经验才能使用图像到图像工具吗?

无需设计经验。图像到图像的AI生成器专为首次创作者而设计:将照片放入上传区域,选择一个模型,输入简短提示,然后点击生成。5到15个单词的提示模式是任何风格、情绪或构图变化的可靠起点。

3

我可以上传多少张参考图片?

Viddo AI 图像到图像上传区域一次最多接受 16 张参考图像。画布中的上传计数器显示为 `image(0/16)`,因此您始终可以看到当前运行剩余的参考空间。

4

Viddo AI上有哪些图像到图像模型可用?

Viddo AI的图像到图像生成器在一个下拉菜单中展示了11个旗舰模型:GPT 2.5 图像、GPT 图像 2、Nano Banana 2、Grok Imagine、Seedream 5 Pro、Nano Banana Pro、Seedream 4.5、GPT 图像 1.5、Nano Banana、GPT 4o 和 Midjourney。每个模型都有自己专门的页面,以提供更深入的提示指导。

5

图像到图像生成器适合商业项目吗?

是的。Viddo AI 的图像到图像生成器旨在用于商业用途——营销视觉、产品模型、品牌资产、内容制作和电子商务列表都是预期工作流程的一部分。在发布之前,请查看 Viddo AI 计划页面上的最新许可条款。

6

生成一张新图像需要多长时间?

大多数图像到图像的生成在几秒钟内完成,具体取决于所选模型的复杂性、分辨率等级和源照片的大小。1K 生成速度最快;4K 生成时间较长,但仍保持在同一画布会话中,因此您可以继续迭代而无需重新加载。
发现更多

在Viddo AI上开始使用图像到图像功能

打开Viddo AI的图像到图像生成器,上传一张源照片,并在一个画布上对11个旗舰图像到图像模型运行相同的简报——无需切换平台,无需重新上传,无需为每个模型使用单独的编辑器。
在Viddo AI上开始使用图像到图像功能
viddo.ai

Viddo AI 是一款先进的一体式人工智能视频和图像生成平台,可让您快速轻松地从各种输入创建令人惊叹的视频和图像。 这些人工智能模型由 Google、OpenAI、Grok AI、ByteDance、Alibaba、Kling、Runway、Vidu、Minimax、Elevenlabs、Midjourney 等提供支持。

© 2026 viddo.ai. All rights reserved.