llms

画像から画像へのAI:あなたの画像を再スタイル、再想像、リミックスする

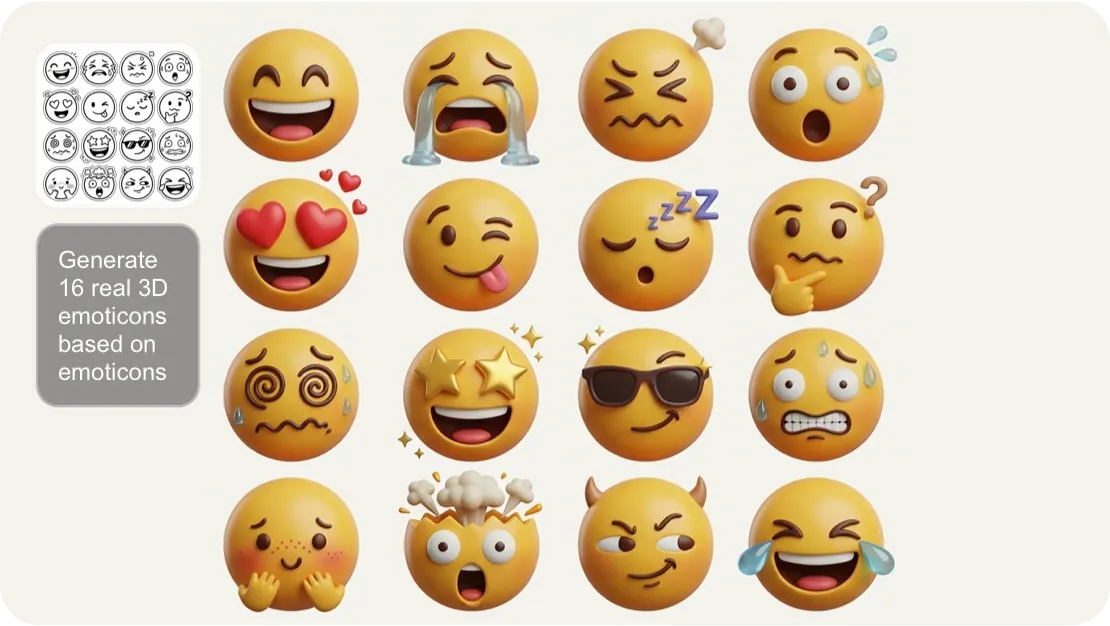
Viddo AIの画像から画像へのAIは、再撮影することなく任意の写真を新しいビジュアルに変換します。画像をアップロードし、20以上のフラッグシップな画像から画像へのモデル(GPT Image、Seedream、Nano Banana、Midjourneyなど)から選択して、出力を数秒でスタイル変更したり、新たに想像したり、リミックスしたりできます。すべてが1つのキャンバス内で行えます。

AIで生成

満足できない場合は、再生成するか、自分用のプロンプトを入力できます。

画像のアスペクト比を選択してください

1:1

3:2

2:3

Medium
High
必要なクレジット: 0

Waiting for your creations!

Viddo AIの画像から画像へのAIジェネレーター

私たちの画像から画像へのツールを使用して、写真を簡単に魅力的な新しいビジュアルに変換し、クリエイティブプロジェクトや広告キャンペーン、ソーシャルメディアコンテンツに最適です。

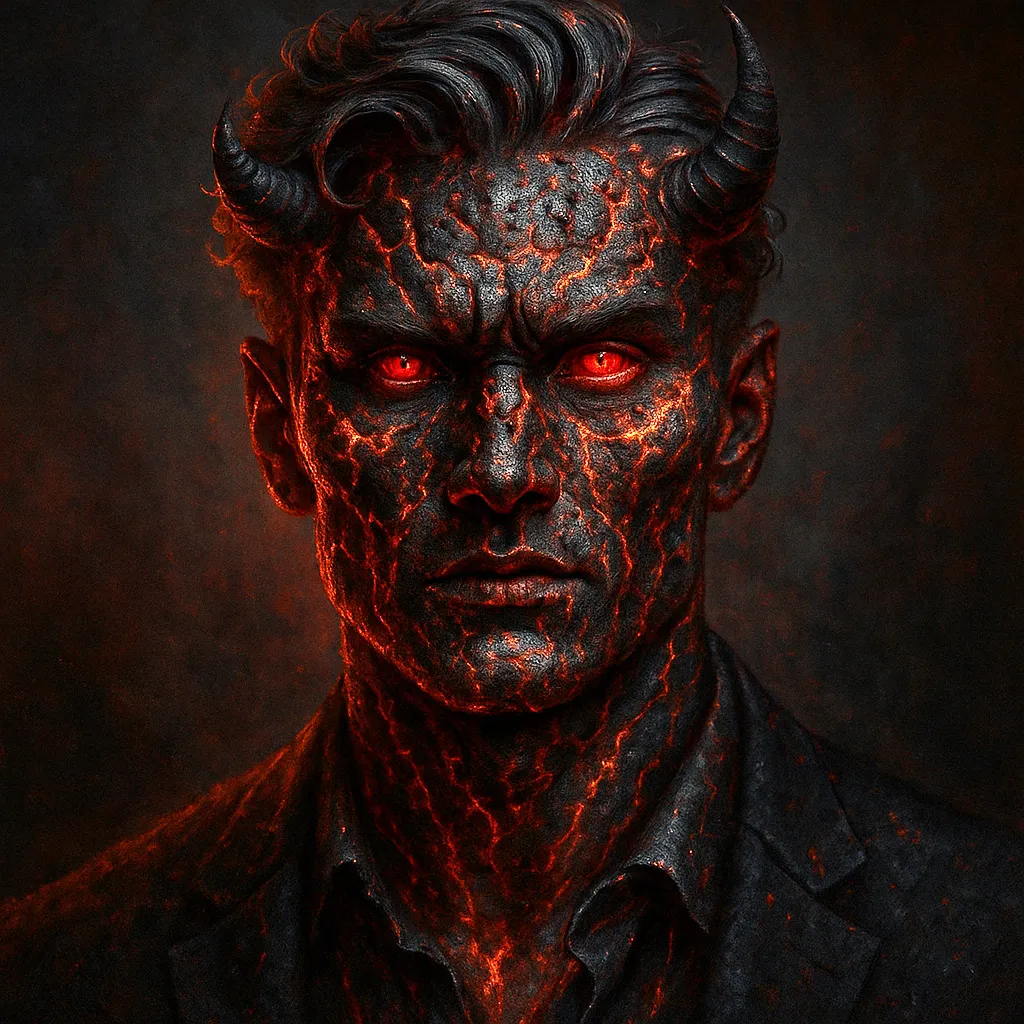
  • Silver-haired man in suit: source image for Viddo AI image to image transformation
    Demonic man with glowing red skin: AI reimagined result from Viddo AI image to image
  • Luxury mechanical watch: base image for Viddo AI image to image style transfer
    Cyberpunk sci-fi watch: futuristic redesign via Viddo AI image to image
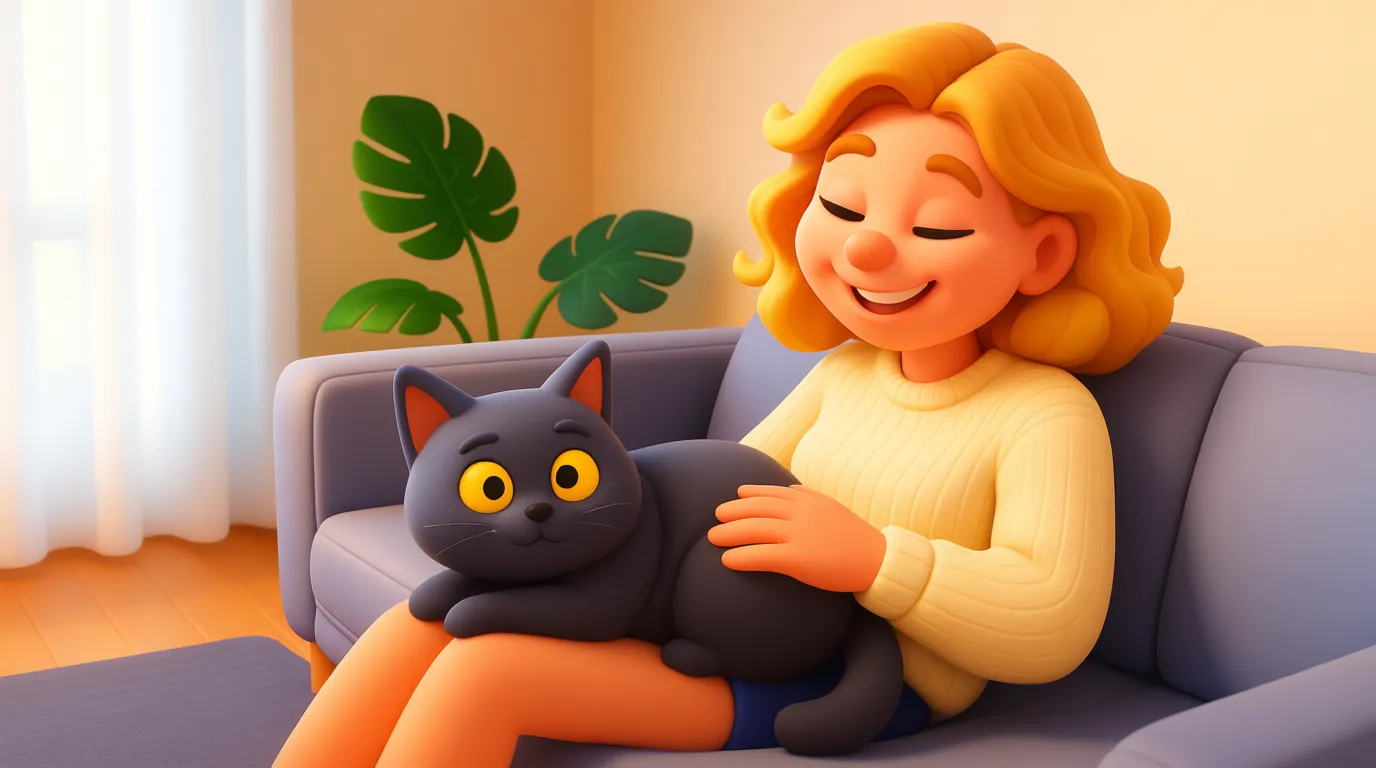
  • Woman with grey cat on couch: source photo for Viddo AI image to image
    Cartoonized woman with cat: playful illustration from Viddo AI image to image
  • Woman with grey cat on couch: source photo for Viddo AI image to image
    Cartoonized woman with cat: playful illustration from Viddo AI image to image

画像キャンバス:Viddo AIでマークした場所を編集する

上記の画像から画像へのジェネレーターはテキストプロンプトに基づいて全体のフレームを再スタイルしますが、Viddo AIのImage Canvasは特定の領域を変更する必要がある場合のオンライン編集コンパニオンです。
image

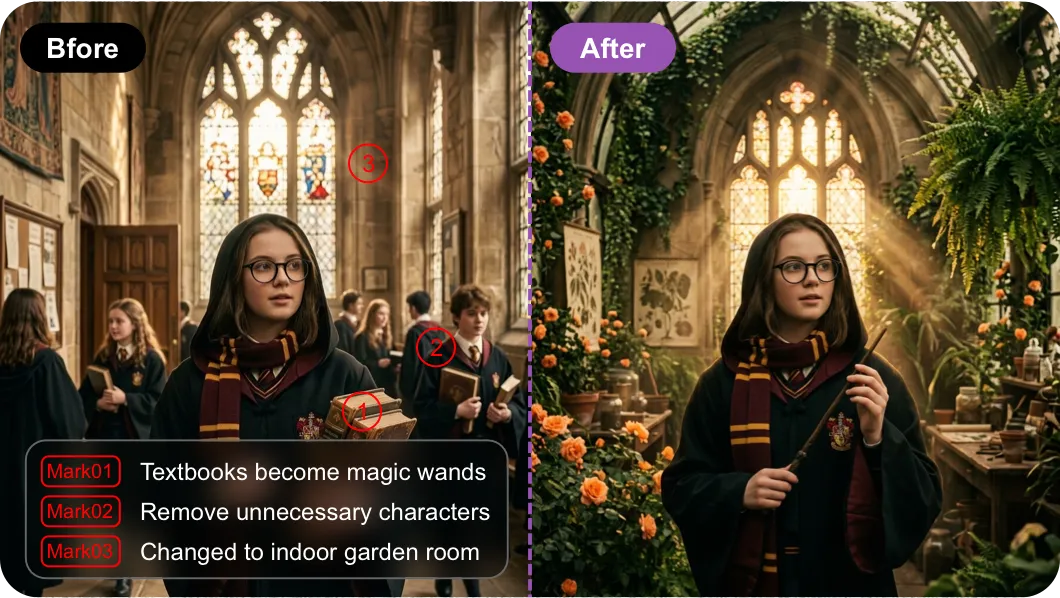
マークモード — 領域を編集するにはクリックしてください

マークパレットから色を選び(赤、緑、青、紫、白)、変更したい領域を塗りつぶすと、そのペイントが名前付きタグになります — @Mark01, @Mark02 など。プロンプトでそのタグを参照すると、モデルはその領域のみを編集し、それ以外の部分はピクセル同一のままです。
image

ドゥードルモード — 上に新しい形を描く

ドゥードルモードはマークの逆です — 画像の上に新しい形を直接スケッチすると、モデルがフォトリアルな詳細でそれを埋めます。マークとドゥードルは同じ編集内で組み合わせることができます:領域をマークし、次に来るものをドゥードルし、生成します。

Viddo AIの画像から画像への主な機能

1つのアップロードゾーンに20以上の画像から画像へのモデル
ピッカーは、OpenAI、Google、ByteDance、xAI、およびMidjourneyの5つのファミリーから14モデルを保持しており、それぞれがフィルターをかけたテキストから画像への変換ではなく、本物の画像から画像への変換を実行します。各モデルは独自のスタイルフィンガープリントとプロンプト感度を持っているため、適切な選択は必要な見た目に依存します。

すべてのモデルは同じアップロードゾーンと同じプロンプトエディタの背後にあり、切り替えても入力形式は変更されません。専用ページでは、それぞれのモデルのプロンプトスタイルについてさらに詳しく説明しています:Seedream 4.5、Nano Banana Pro、およびMidjourney。
1つのアップロードゾーンに20以上の画像から画像へのモデル
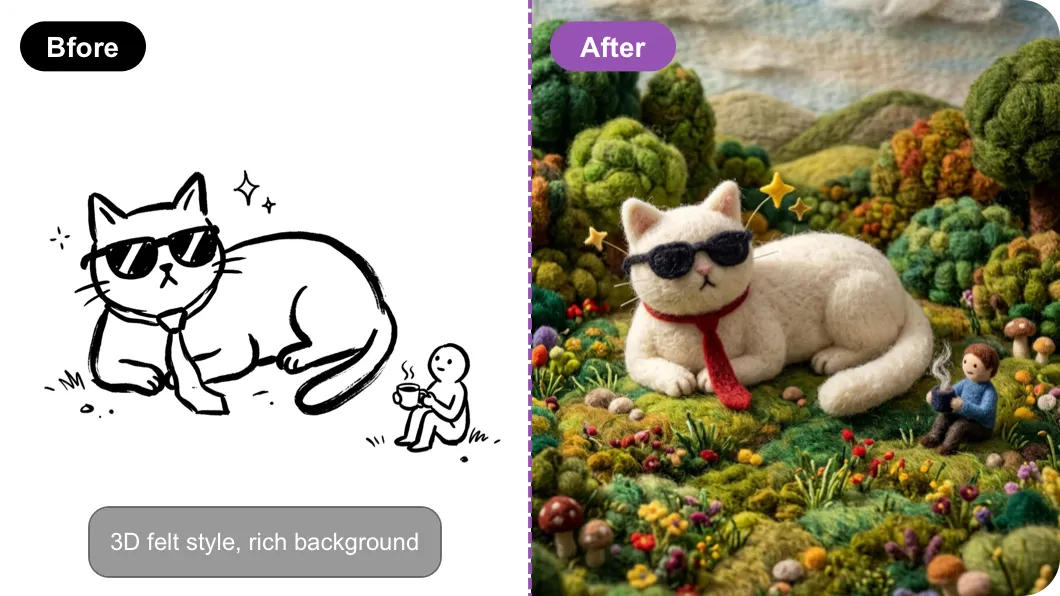
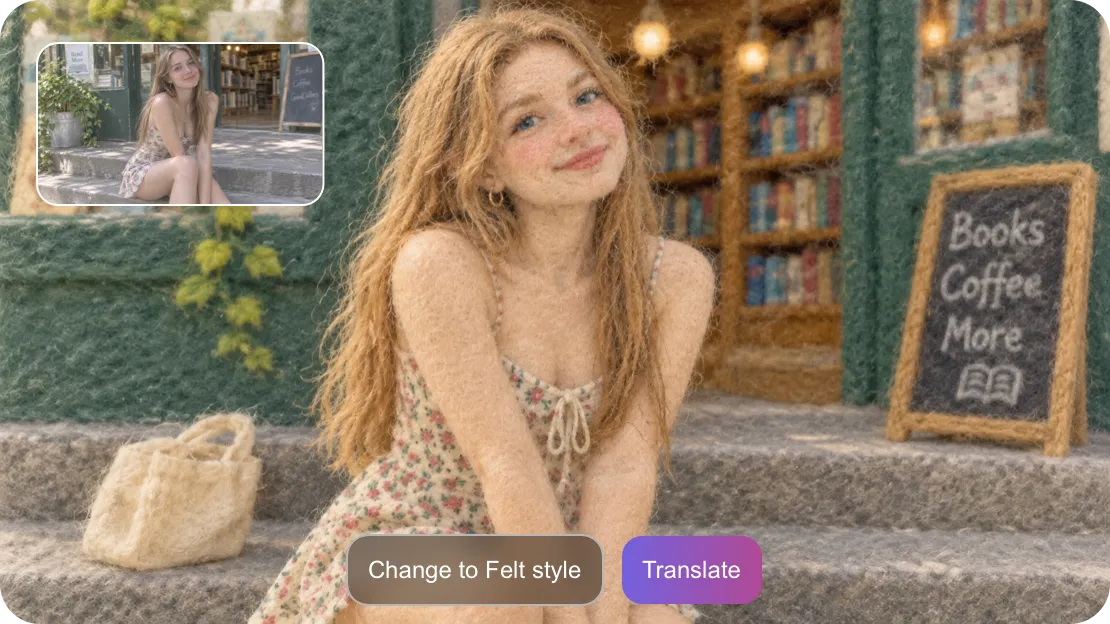
テキストプロンプトによるスタイル転送
画像から画像へのAIジェネレーターは、スタイル転送を第一級の出力として扱います。ターゲットとなる美学に合ったモデルを選択してください — アニメ、シネマティック、クレイアニメーション、水彩画、フォトリアル — そしてそのモデルは元の構図を保持しながら、そのスタイルで写真を再レンダリングします。ソース写真が構造を決定し、プロンプトが見た目を決め、モデルは隅から隅まで一貫したカットを維持します。これがアニメのリスキンやミュージックビデオのカラーグレーディング、ブランドKVの一貫性、およびショートフォーム広告の再利用に関するワークフローです — 「同じ構図でシネマティックなカラーグレード」といった短いプロンプトを書けば、モデルが残りを処理します。
テキストプロンプトによるスタイル転送
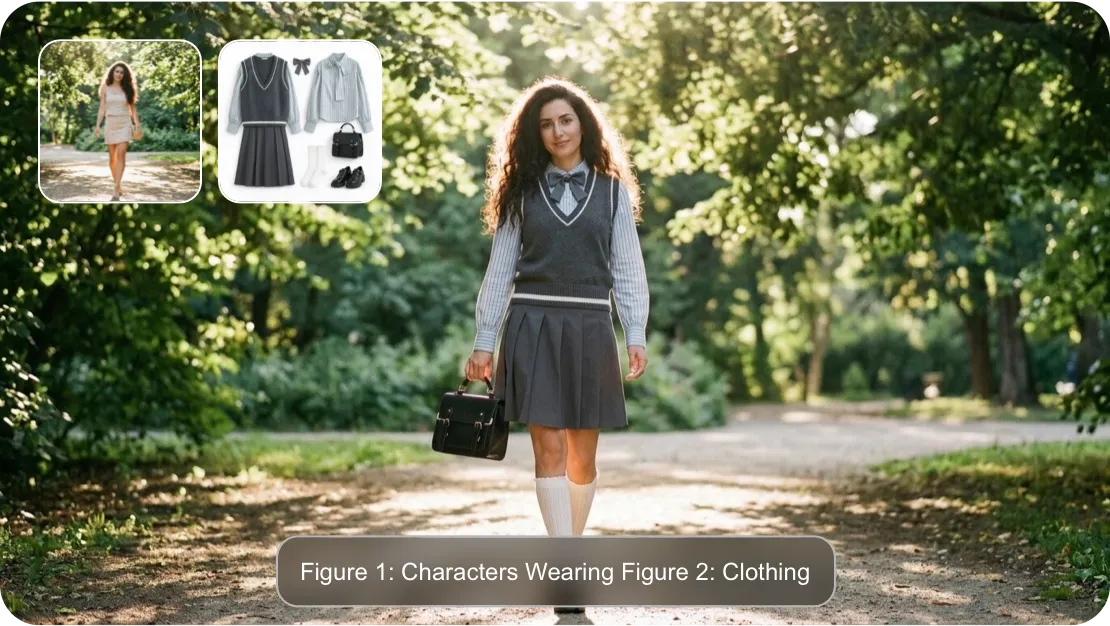
1つのブリーフに最大16枚の参照画像
Viddo AIの画像から画像へのAIジェネレーターは、1つのブリーフで最大16枚の参照画像を受け付けます。ソース画像をアップロードゾーンにドラッグし、ターゲットスタイル、ムード、またはキャラクターに合った参照写真を追加すると、モデルは作業中に各参照をインデックス化します。キャンバス内のアップロードカウンターには「image(0/16)」と表示されるため、ブリーフがまだ吸収できる参照数が常にわかります。マルチリファレンスはブランドKVシリーズやキャラクター回転シート、多フォーマットキャンペーンビジュアル、および複数の出力間で安定したアイデンティティが必要な任意のブリーフの背後にあるワークフローです。
1つのブリーフに最大16枚の参照画像
アスペクト比、解像度、およびバージョン管理
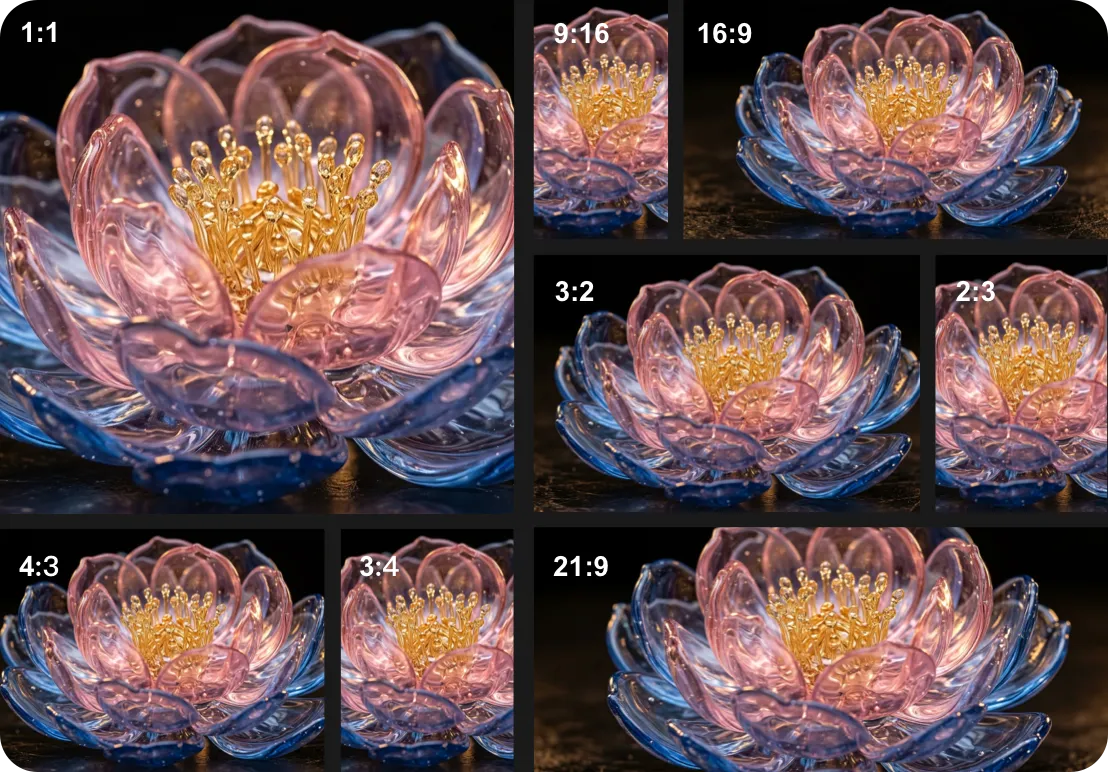
画像から画像へのAIジェネレーターは、9つのアスペクト比(適応型、1:1、16:9、9:16、4:3、3:4、3:2、2:3、21:9)、3つの解像度階層(1K, 2K, 4K)、およびサポートされているモデルでの2つのモデルバージョン(フレアとサンバースト)を提供し、その出力が配置に合うようになっています。ソーシャルアバターには1:1を選択し、ストーリー用カットには9:16を選び、大ヒーローバナーには16:9を選ぶか、自動的にソースに合った比率をモデルが選ぶようにするために適応型を選んでください。迅速な反復作業には1Kを選択し、最終エクスポートには4Kを使用し、お同じプロンプトに対して同じモデルの二つの生成物を比較するためにフレアとサンバースト間で切り替えてください。
アスペクト比、解像度、およびバージョン管理
シリーズ全体の視覚的一貫性のためのシードロック
Viddo AIの画像から画像へのAIジェネレーターには、シードロックコントロールが搭載されています。一度シードを選択すると、同じプロンプトとシードで実行するたびに同じスタイルフィンガープリント、キャラクターの外観、およびパレットベースラインが返されます。画面上のツールチップによれば、「同じシード値を使用することで、画像のスタイルとキャラクターの外観をできるだけ一貫性を持たせることができます — シリーズを作成したり視覚的な一貫性を維持するために最適です。」シードロックはブランドKVシリーズ、エピソディックキャラクターアート、多フォーマットキャンペーンカット、および複数の画像間で安定したアイデンティティが必要なブリーフにおけるワークフローです。
シリーズ全体の視覚的一貫性のためのシードロック
多言語ブリーフの翻訳プロンプト
Viddo AIの画像から画像へのAIジェネレーターには、プロンプトエディタの横にワンクリック翻訳ボタンがあります。16種類のサポートされている言語のいずれかでブリーフを書くと、Viddo AIはそれをモデルのお気に入りのプロンプトスタイルに書き換えます。その後、画像から画像へのAIモデルに届きます。翻訳は、多言語キャンペーン制作や地域間eコマースリスティング、1つの言語でブリーフを作成し別の言語へ出荷するチームなどのワークフローです。Viddo AIはドロップダウン内のすべてのモデル横に翻訳ボタンを配置しており、同じワンクリック翻訳が11モデル全体で流れるようになっています。
多言語ブリーフの翻訳プロンプト

Viddo AIの画像から画像へのプロンプト例

Every prompt below follows a 5-part structure that Viddo AI's Image to Image models recognise reliably:

StyleSubjectReferenceAspectMood

Use a 3-part brief (Style + Subject + Mood, 5-9 words) when the source photo already supplies the Reference and Aspect.

Use a 5-part brief (10-15 words) when you need to pin the face, product, or crop explicitly.

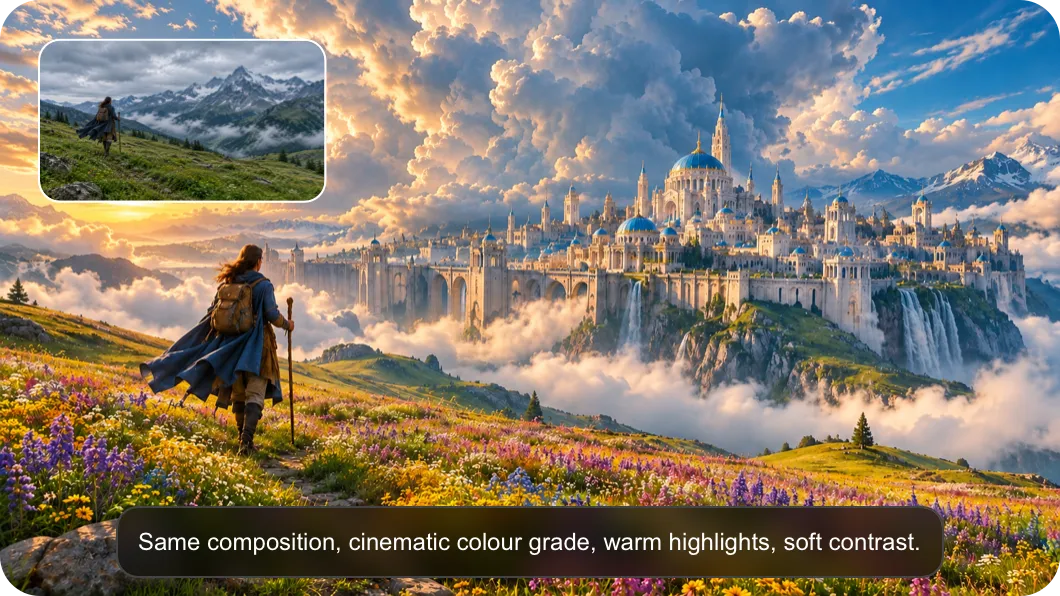
同じ構図のシネマティックなカラーグレーディングで、暖かいハイライトと柔らかなコントラスト。

プロンプト 1 — シネマティックカラーグレード

構造

スタイル: シネマティックカラーグレード
主題: 同じ構図
参照: (なし - ソース写真を使用)
アスペクト: (ソース比率)
ムード: 暖かいハイライト、柔らかいコントラスト

なぜ機能するのか

  • 同じ構図 — モデルにレイアウトを保持し、再スタイルするよう指示する
  • シネマティックカラーグレード — GPT Image 2とSeedream 4.5で広色域+ティールオレンジスプリットトーンルックを引き起こす
  • 暖かいハイライト、柔らかいコントラスト — 照明バイアスを固定し、すべての再実行が一貫して見えるようにする
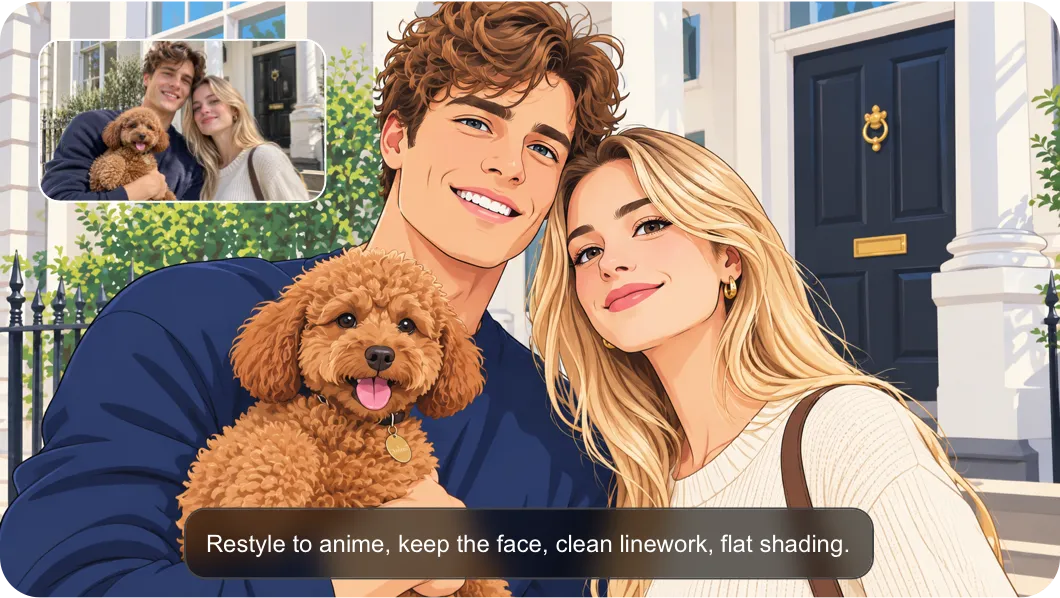
オリジナルの顔を保ちながら、クリーンな線画とフラットシェーディングでアニメスタイルを再構築。

プロンプト2 — フェイスロック付きアニメリスキン

構造

スタイル: アニメ
テーマ: アニメへのリスタイル
参照: 顔を保持する
アスペクト: (ソース比)
ムード: クリーンなラインワーク、フラットシェーディング

なぜ機能するのか

  • 顔を保持する — Nano Banana ProとMidjourneyは、明示的に指示された場合にアイデンティティを保つ
  • アニメ + クリーンなラインワーク、フラットシェーディング — モデルが毎回異なるアニメ美学を選ばないようにアニメサブスタイルを絞る
  • キャラクターターンアラウンドシートに最適 — シリーズ全体でSeed Lockと組み合わせる
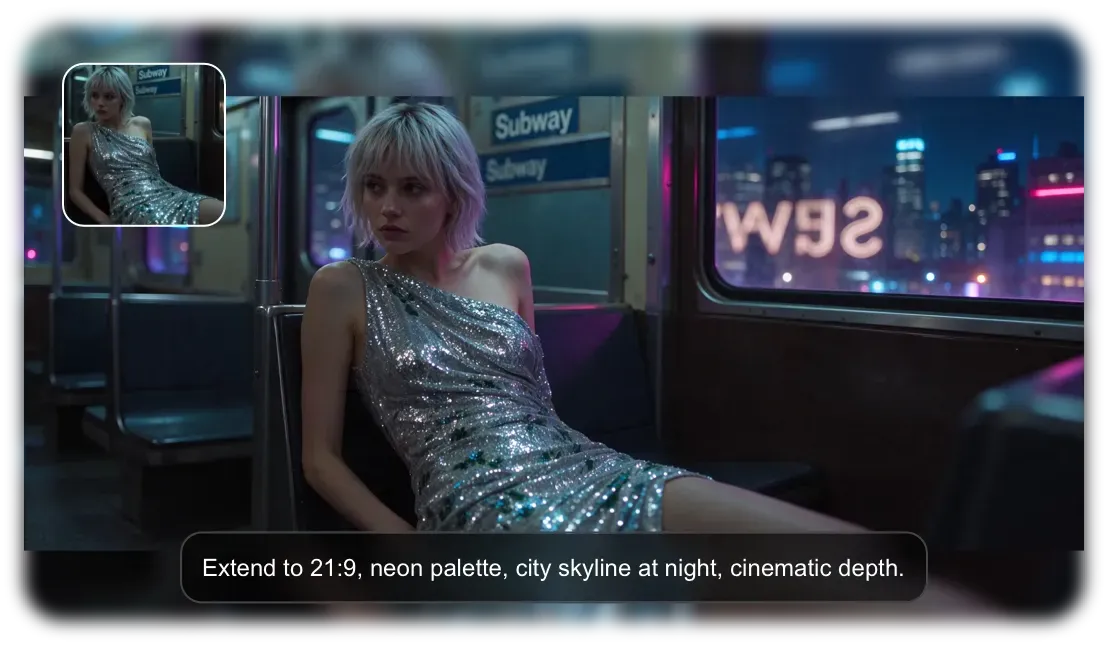
都市のスカイラインが21:9のシネマティックフレームに拡張され、ネオンパレットで彩られています。

プロンプト3 — 21:9への横長拡張

構造

スタイル: シネマティック
テーマ: 21:9に拡張
参照: 都市のスカイライン
アスペクト比: 21:9
ムード: ネオンパレット、シネマティックな深み

なぜ機能するのか

  • 21:9に拡張 — クロップターゲットを設定; モデルは新しいエッジを同じ美学で満たす
  • 夜の都市スカイライン — 拡張されたエッジのためにモデルにコンテンツアンカーを提供(一般的なぼやけではなく)
  • シネマティックな深み — Seedream 5 ProとGPT Image 2を前景/中景/背景レイヤリングへ押し進める
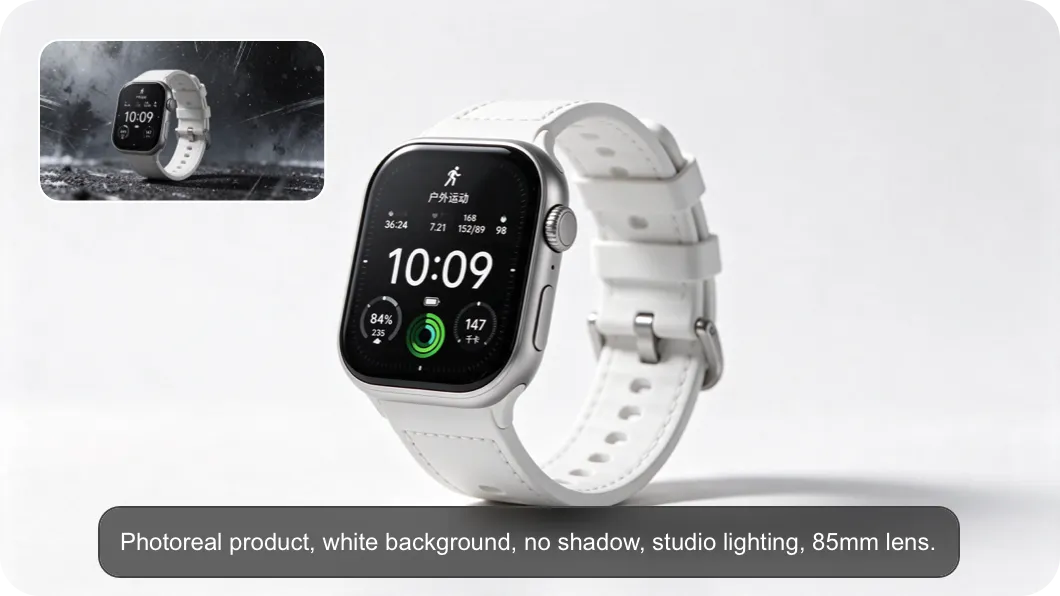
白い背景にスタジオ照明があり、影のない製品写真

プロンプト4 — 白背景の製品

構造

スタイル: フォトリアル
主題: 白背景の製品
参照: ソース製品
アスペクト比: 1:1
ムード: スタジオライティング、影なし、85mmレンズ

なぜ効果的か

  • 白背景、影なし — 最もクリーンなeコマースヒーローブリーフ; GPT Image 2とGPT-4oはこれを完璧に実現している
  • 85mmレンズ — フォトリアルモデルで製品写真行動を引き起こす実際の焦点距離
  • Amazom / Shopify / Etsyリスティング用にドロップイン可能
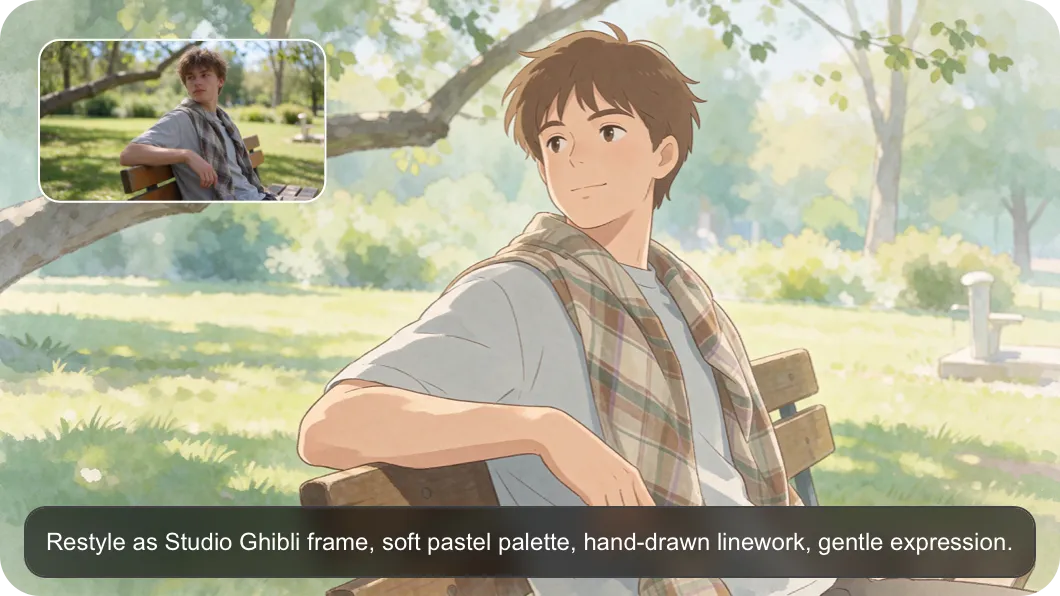
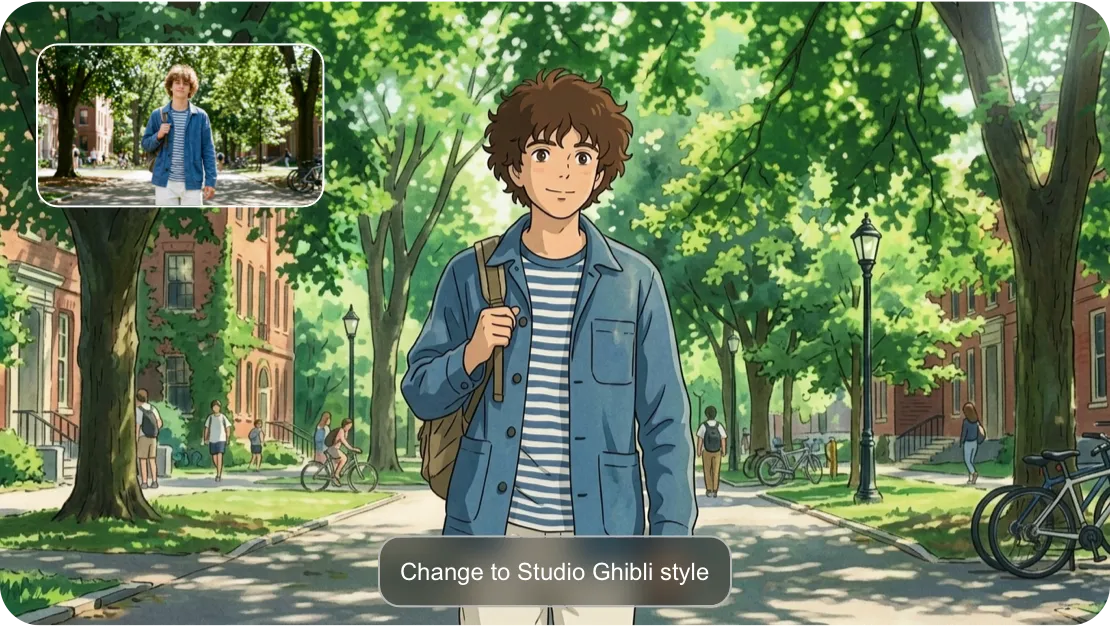
スタジオジブリのイラスト、柔らかいパステルパレットと手描きのラインワークを使用しています。

プロンプト5 — スタジオジブリのイラスト

構造

スタイル: スタジオジブリのイラスト
テーマ: イラストとして再スタイル
参考: (構図のアンカーとしてのソース写真)
アスペクト: (ソース比率)
ムード: ソフトパステルパレット、手描きの線画、優しい表情

なぜ機能するか

  • スタジオジブリ — MidjourneyとGrok Imagineが認識する特定の参照であり、あいまいなアニメとは異なる
  • ソフトパステルパレット + 手描きの線画 — 色温度とストロークスタイルを固定する
  • 優しい表情 — モデルを友好的で非脅威的なキャラクター作業に導く
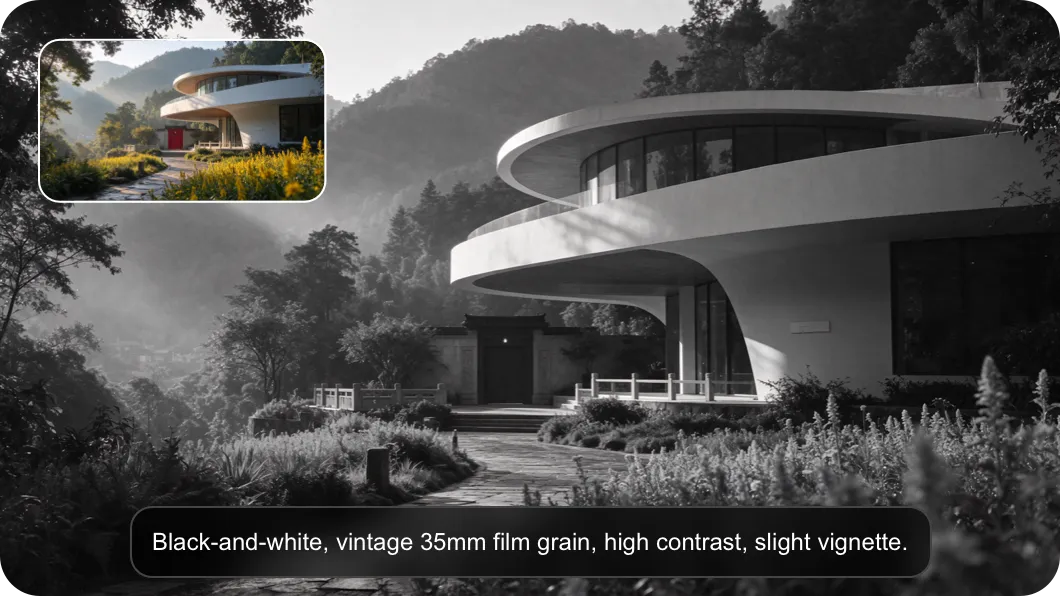
35mmフィルムの粒子感がある白黒のヴィンテージ写真、高コントラスト、わずかなビネット付き

プロンプト6 — 白黒フィルムの粒子

構造

スタイル: 白黒ビンテージ
主題: (ソース写真)
参照: (なし)
アスペクト: (ソース比率)
ムード: 35mmフィルムグレイン、高コントラスト、わずかなビネット

なぜ機能するのか

  • ビンテージ35mmフィルムグレイン — 明示的にフィルムストックを参照し、GPT Image 1.5とSeedream 4.5はどちらも既知の美学にマッピングされる
  • 高コントラスト — トーンカーブを固定する
  • わずかなビネット — 構図を圧倒せずにフレームエッジを追加する
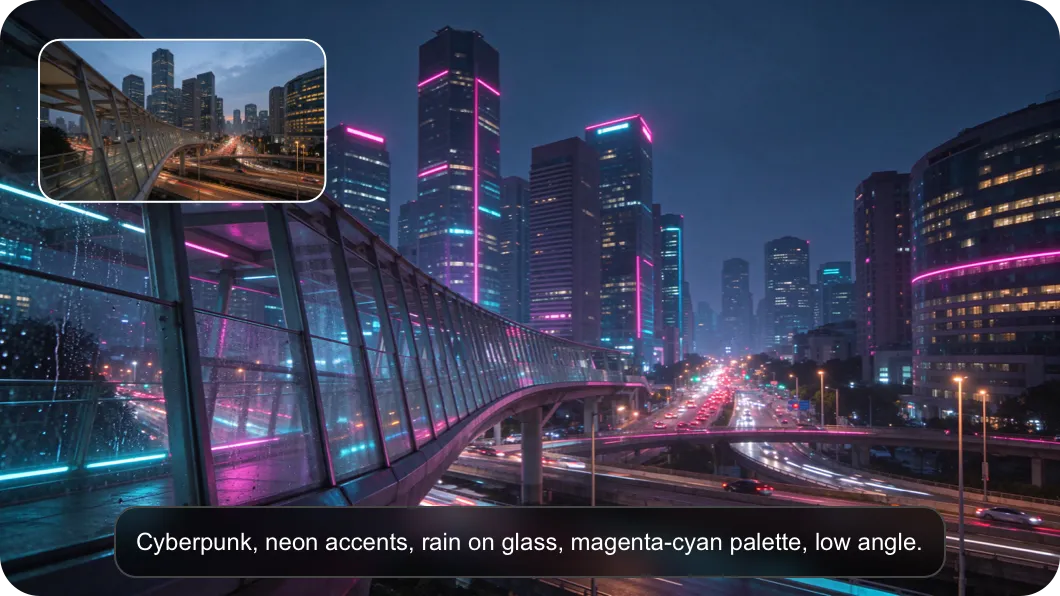
ネオンアクセント、ガラスに降る雨、マゼンタ-シアンのパレットを使用した16:9のサイバーパンクスタイル

プロンプト7 — サイバーパンクミュージックビデオ

構造

スタイル: サイバーパンク
テーマ: (ソース写真)
参考: (なし)
アスペクト: 16:9
ムード: ネオンアクセント、ガラスの雨、マゼンタ-シアンパレット、低角度

なぜ機能するのか

  • マゼンタ-シアンパレット — Seedream 5 ProとGrok ImagineをSF音楽ビデオ美学に押し上げる特定の色の組み合わせ
  • ガラスの雨 — 構成を変えずにテクスチャーを追加する
  • 低角度 — 主題を劇的に再フレーミングするカメラキュー
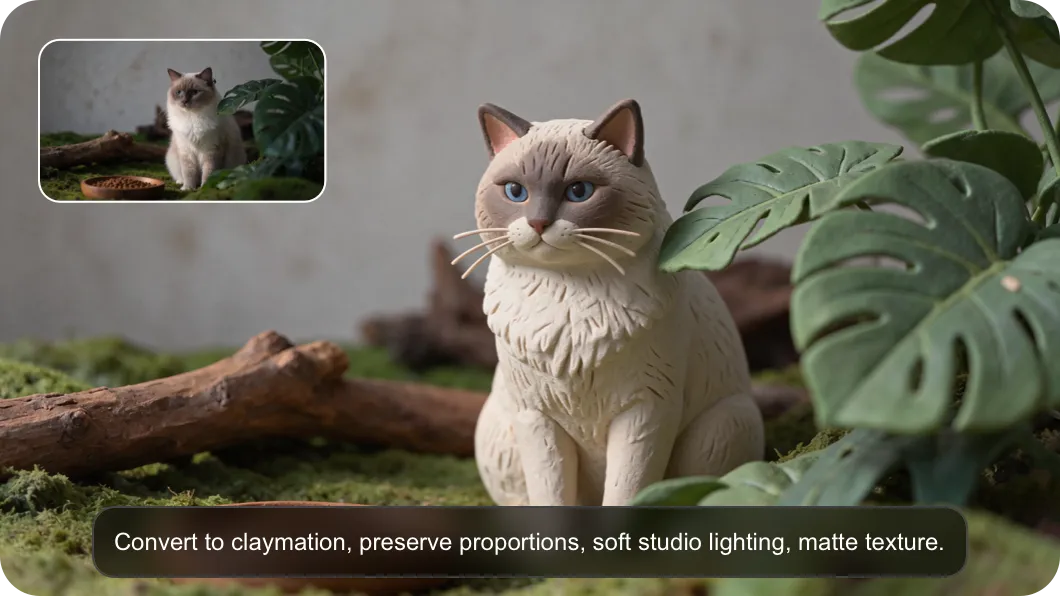
プロポーションを保ちながら、柔らかなスタジオライティングとマットな質感で再スタイルされたクレイメーション

プロンプト8 — クレイマションの再スキン

構造

スタイル: クレイマーション
テーマ: クレイマーションに変換
参照: (ソース写真)
アスペクト: (ソース比率)
ムード: 比率を保つ、柔らかいスタジオライティング、マットテクスチャ

なぜ機能するのか

  • 比率を保つ — MidjourneyとGrok Imagineはこれを尊重し、ソースシルエットを保持します
  • クレイマーション + マットテクスチャ — ストップモーションの美学を狭めるため、モデルはプラスチックやワックスよりも粘土を選びます
  • 柔らかいスタジオライティング — 粘土にはない厳しい鏡面ハイライトを排除します

画像から画像へのAIの使い方

1
画像から画像へのツールを開く
任意の最新ブラウザでviddo.ai/image-to-imageを開いてください。ワンクリックでViddo AIアカウントにサインインまたは作成できます。画像から画像へのキャンバスはURLですぐに読み込まれます。モデルピッカー、アップロードゾーン、プロンプトエディタ、アスペクト比と解像度のコントロール、生成ボタン、および最新と履歴のタブがすでに画面上に表示されています。ダッシュボードを移動する必要もなく、別ページへのモデル切り替えもありません。
2
モデルを選択し、画像をアップロードしてください。
キャンバスの上部にあるモデルピッカーをクリックし、11種類の画像から画像へのAIモデルのいずれかを選択します。最初はGPT 2.5 Imageで素早く試すか、特定のスタイルの場合はSeedream 5 Pro、Nano Banana Pro、またはMidjourneyに直接ジャンプしてください。ソース画像をアップロードゾーンにドラッグ&ドロップするか、自分のデバイスから選択するためにクリックします。アップロードカウンターには`image(0/16)`と表示されており、どれだけ参照スペースが残っているかがわかります。
3
プロンプトを書く(または翻訳をクリック)
プロンプトエディタに短い指示を入力してください — 新しい画像が持つべきスタイル、ムード、または変化を説明します。最も効果的な結果を得るために、プロンプトは5〜15語の範囲で保ってください。英語以外の言語で要約する場合は、プロンプトエディタの横にある翻訳ボタンをクリックすると、Viddo AIが選択したモデル用にプロンプトを書き直します。
4
アスペクト比と解像度を選択し、生成してください。
配置に合ったアスペクト比(1:1、16:9、9:16、4:3、3:4、3:2、2:3、21:9 または アダプティブ)と解像度の階層(1K、2K または 4K)を選択してください。生成をクリックすると結果が最新タブに表示されます。同じブリーフで再アップロードせずにモデルを切り替え、お望みの見た目になったら最終出力をダウンロードします。

画像から画像ツールの恩恵を受けられる人は誰ですか?

マーケターと広告クリエイティブ

製品写真をスタイライズされたキャンペーンビジュアルに変換し、ソーシャルメディア広告、メール、およびディスプレイ用に使用します。画像から画像へのAIジェネレーターは、A/Bテスト、季節プロモーション、およびチャネル特有のトリミング用のバリエーションやモックアップを作成するのに最適です。同じソース写真から1:1のInstagramカット、9:16のストーリーカット、および16:9のヒーローバナーを一つのワークスペースで生成できます。

コンテンツクリエイターとインフルエンサー

ソーシャルメディアのフィードやショートフォーム動画のサムネイル用に、目を引くテーマ別のビジュアルを生成します。画像から画像へのAIジェネレーターは、クリエイターがシリーズ全体で一貫したビジュアルアイデンティティを維持する手助けをします — 同じキャラクター、同じパレット、同じ構図 — スタジオを予約したり、すべてのバリエーションごとにリタッチャーに支払ったりすることなく。

写真家とビジュアルストーリーテラー

写真を強化し、代替バージョンを生成し、オリジナルのRAWスタイルの構成から離れることなく芸術的な効果を追加します。画像から画像へのAIジェネレーターは、フォトグラファーにとってカラーグレードやムード処理、スタイライズされた再レンダリングをテストするための迅速な方法を提供します。これは編集提案やクライアントレビュー、ポートフォリオ拡張に役立ちます — 単一のアップロードが午後中に十数のクリエイティブな方向性になる可能性があります。

ゲームデザイナーとコンセプトアーティスト

キャラクター、環境、プロップを粗いアイデアから洗練されたビジュアルへと進化させることで、コンセプト開発を加速します。画像から画像へのAIジェネレーターは、迅速なブロックインスケッチを取り込み、それを完成したコンセプトイラストやターンアラウンドシート、多角的なキャラクタースタディとして再レンダリングします。マルチリファレンスアップロードゾーンは、複数のアセット間で一貫性を保つ必要があるプロップシート、ムードリファレンス、およびライティングスタディ用に構築されています。

デジタルアーティストとイラストレーター

スケッチを再構築し、構図を強化したり、新しいアートスタイルを最小限の労力で探求したりします。画像から画像へのAIジェネレーターは、粗い線画を選択したスタイル(水彩、インク、セルシェーディング、油彩、リソグラフ)で完成されたイラストとして再レンダリングしながら、アーティストの元の構図を保持します。シードロックを使用して、一連のスタイル実験においてキャラクターが認識可能な状態に保ちます。

Eコマースの販売者と製品マーケター

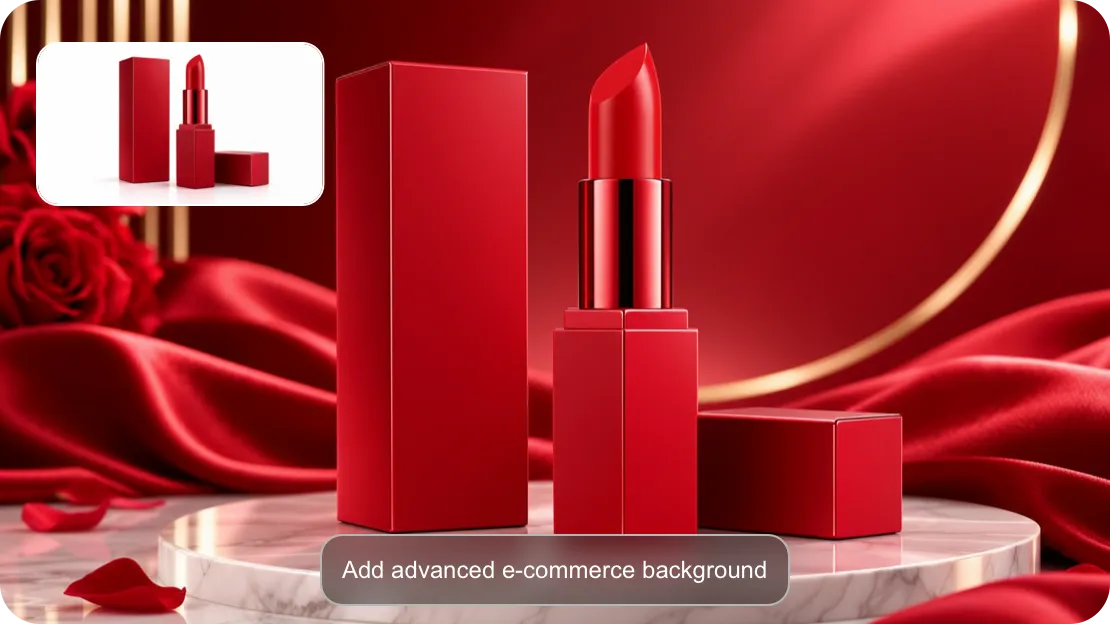
白背景の製品写真を完全なキャンペーン資産ライブラリに変換します:ライフスタイル配置、季節感、ギフト用ヒーロー、およびプラットフォーム特有のトリミング。画像から画像へのAIジェネレーターは、マルチリファレンスアップロードゾーンと9比率ピッカーを組み合わせているため、単一の製品写真が1つの作業スペースでInstagramスクエア、ストーリーズ縦型、市場向けヒーロー、およびメールバナーなどの完全な小売キットに変わります。

Viddo AIの画像から画像への幸せなユーザー

レナ・M、コンセプトイラストレーター

Viddo AIの画像から画像へのジェネレーターは、私がデジタルアーティストとして働く方法を完全に変えました。ラフな線画をアップロードゾーンにドロップし、MidjourneyまたはNano Banana Proを選択すると、2日間かけて描いていたスタイルで完成したイラストが返ってきます。Seed Lockは、12ページのシリーズ全体で主人公を認識可能に保ちます — 同じ顔、同じパレット、すべてのページで。

クリス・T、フリーランスデザイナー

私は毎週、5人のリテイナー顧客のキャンペーンビジュアルをモックアップするためにImage to Imageツールを使用しています。クライアントの商品写真をアップロードし、短いプロンプトを入力して、同じクリエイティブの1:1、9:16、および16:9バージョンを一午後で出荷します。Photoshopでの作業時間は約70%削減されており、クライアントからの修正依頼も最初から意図的に見えるバリエーションのおかげでよりクリーンなフィードバックが返ってきます。

モーガン・L、ブランドストラテジスト

マーケターとして、ブランドの写真をシーズン分のソーシャルアセットに変換できるツールが必要でしたが、ブランドKVを失うことはありません。Viddo AIのImage to Imageジェネレーターはまさにそれを実現します — Seed Lockとマルチリファレンスアップロードゾーンのおかげで、私たちのヒーロープロダクトは夏、秋、ホリデーカットでも認識可能です。11モデルのラインナップにより、同じブリーフでMidjourneyとNano Banana ProをA/Bテストし、そのチャネルに合った見た目を選ぶことができます。

デヴ・R、コンテンツクリエイター

私は6ヶ月間、ソーシャルメディアでAIスタイルのポートレートを公開しています。Viddo AIは、ヒンディー語でブリーフを作成し、「翻訳」をクリックするだけで手動でブリーフを書き直すことなく完成した英語のプロンプトを出力できる最初のツールです。4K出力は印刷に十分な鮮明さがあり、9:16カットはそのままReelsに適しています。また、同じソース写真でGPT Image 2とGrok Imagineを切り替えることで、私のフィードには観客が求めている多様性が生まれます。

アレックス・K、写真家

私はViddo AIの画像から画像へのジェネレーターを通じて、ポートレートポートフォリオにAIスタイルのバリエーションを追加しています。同じモデルのフレアとサンバーストバージョンは便利なA/Bペアであり、両方をクライアントに見せて好みのルックを選んでもらいます。シードロックコントロールがこのワークフローを信頼できるものにしているので、2週間後にブリーフに戻ってもキャラクターは同じ人物のように見えます。

ジア・W、インディー映画製作者

画像から画像へのジェネレーターは、私の短編映画のために1日の午後で完全なムードボードを作成するのに役立ちました。各シーンから静止画をアップロードし、シーンごとに12枚のリファレンスフレームを追加し、それぞれに短いプロンプトを使ってNano Banana ProとSeedream 5 Proで処理しました。履歴タブはすべてのイテレーションを保持していたので、一つもドラフトを失うことなくモデル間でムード処理を比較できました。

画像から画像へのAIツールについて詳しく学ぶ

1

画像から画像へのAIジェネレーターとは何ですか?

画像から画像へのAIジェネレーターは、既存の写真を入力として受け取り、テキストプロンプトに基づいて変換された写真を出力するツールです。Viddo AIの画像から画像へのジェネレーターは、11の主要な画像から画像へのモデルを1つのキャンバスに集約しているため、再アップロードすることなく同じソース写真を異なるモデルでスタイル変更したり、新たに想像したり、リミックスしたりできます。

2

画像から画像へのツールを使用するには、デザイン経験が必要ですか?

デザイン経験は必要ありません。画像から画像へのAIジェネレーターは初めてのクリエイター向けに作られています:アップロードゾーンに写真をドラッグし、モデルを選択し、短いプロンプトを入力して「生成」をクリックするだけです。5〜15語のプロンプトパターンは、スタイル、ムード、または構図の変更に対する信頼できる出発点です。

3

何枚の参照画像をアップロードできますか?

Viddo AIの画像から画像へのアップロードゾーンでは、1回のブリーフで最大16枚の参照画像を受け付けます。キャンバス内のアップロードカウンターは`image(0/16)`と表示されており、現在の実行に対してどれだけ参照スペースが残っているかを常に確認できます。

4

Viddo AIにはどのような画像から画像へのモデルがありますか?

Viddo AIの画像から画像へのジェネレーターは、1つのドロップダウンに11のフラッグシップモデルを表示します:GPT 2.5 Image、GPT Image 2、Nano Banana 2、Grok Imagine、Seedream 5 Pro、Nano Banana Pro、Seedream 4.5、GPT Image 1.5、Nano Banana、GPT 4o、およびMidjourney。各モデルにはより深いプロンプトガイダンスのための専用ページがあります。

5

画像から画像への生成器は商業プロジェクトに適していますか?

はい。Viddo AIの画像から画像への生成器は商業利用向けに設計されています — マーケティングビジュアル、製品モックアップ、ブランド資産、コンテンツ制作、およびeコマースリスティングがすべて意図されたワークフローの一部です。公開する前にViddo AIプランページで最新のライセンス条件を確認してください。

6

新しい画像を生成するのにどれくらい時間がかかりますか?

ほとんどの画像から画像への生成は数秒で完了しますが、選択したモデルの複雑さ、解像度のティア、およびソース写真のサイズによって異なります。1K生成は最も早く返されます; 4K生成は時間がかかりますが、同じキャンバスセッション内に留まるため、再読み込みせずに繰り返し作業を続けることができます。

もっと知る

Viddo AIで画像から画像へ始めましょう

Viddo AIの画像から画像へのジェネレーターを開き、ソース写真をドロップし、1つのキャンバスで11のフラッグシップ画像から画像へのモデル全てに同じブリーフを実行します — プラットフォームの切り替えもなく、再アップロードも不要で、各モデルごとに別々のエディターも必要ありません。
Viddo AIで画像から画像へ始めましょう
viddo.ai

Viddo AI は、高度なオールインワン AI ビデオおよび画像生成プラットフォームであり、さまざまな入力から素晴らしいビデオや画像を迅速かつ簡単に作成できます。 これらの AI モデルは、Google、OpenAI、Grok AI、ByteDance、Alibaba、Kling、Runway、Vidu、Minimax、イレブンラボ、Midjourney などによって強化されています。

© 2026 viddo.ai. All rights reserved.